Ciencia de datos y ML · IA y agentes · Full-Stack y UI/UX
SmartSearch: búsqueda para ecommerce, learning to rank y tests A/B
Por David Gadyan · Publicado el
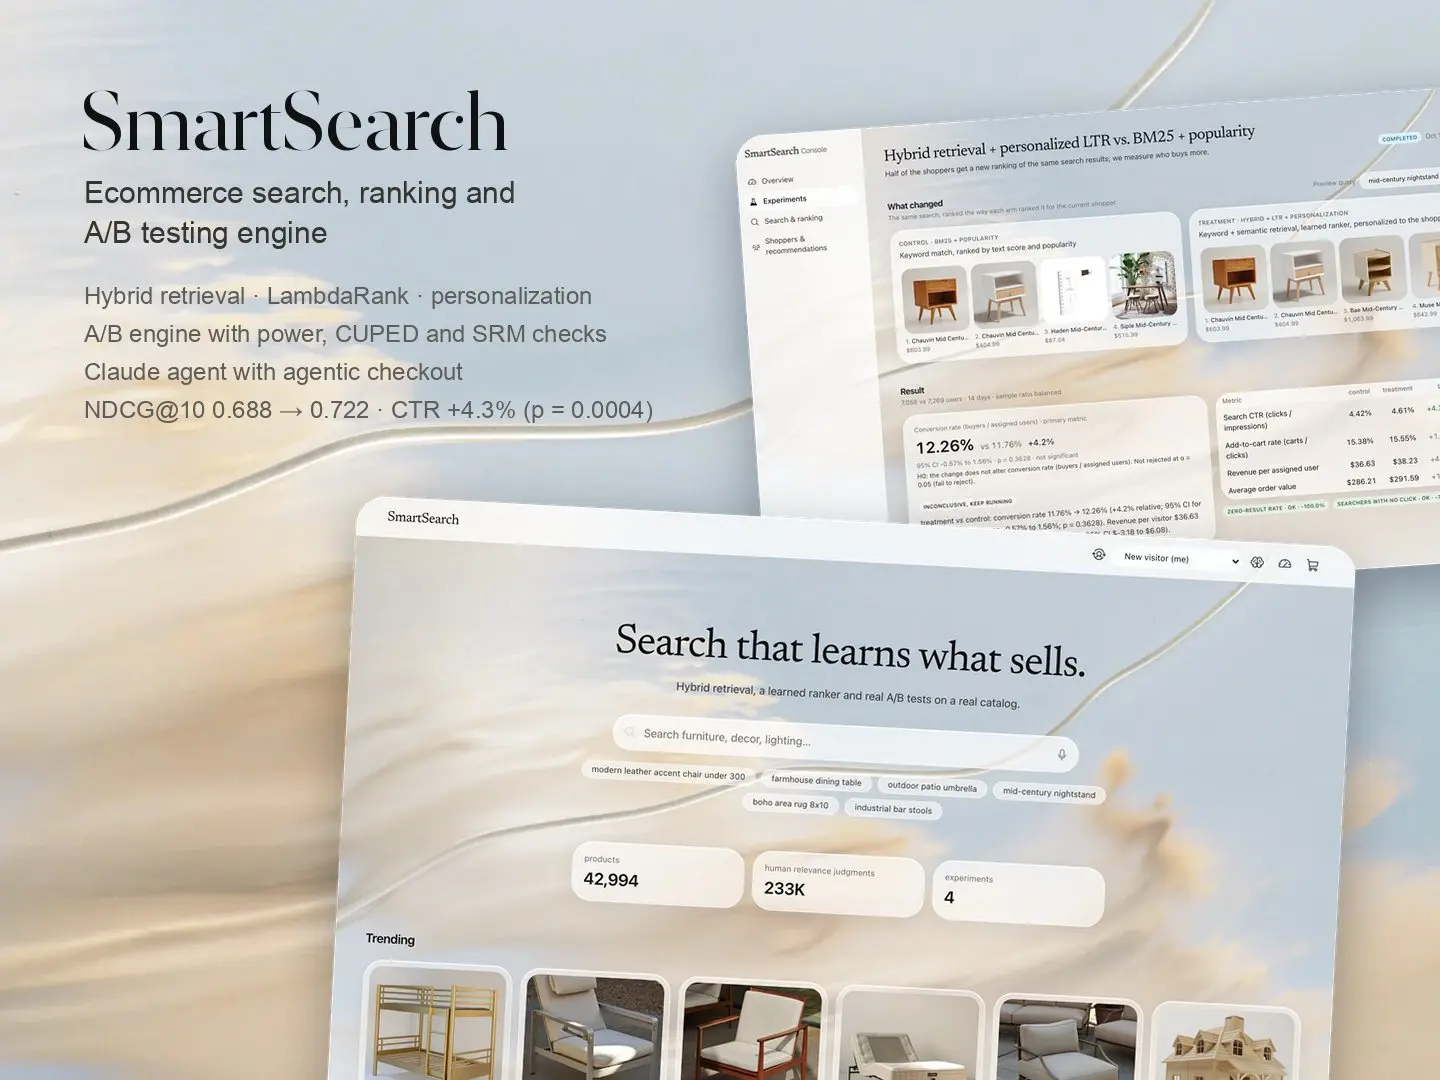
Un buscador para ecommerce construido de principio a fin: los compradores buscan entre 42.994 productos reales de muebles y decoración, la recuperación por palabras clave y la semántica se fusionan, un modelo LightGBM ordena los resultados y cada resultado explica su puntuación. Un motor de experimentación reparte a los compradores al 50/50 y dicta lanzar, seguir midiendo o rechazar, y un asistente con Claude compra y paga por el Agentic Commerce Protocol. El NDCG@10 offline sube de 0,688 a 0,722 sobre 233.000 valoraciones humanas de relevancia; el comportamiento de los compradores es simulado y así se indica. Python, FastAPI, PostgreSQL con pgvector, LightGBM, Next.js, 48 tests de backend.
El problema
Los equipos de búsqueda en ecommerce tienen que demostrar que un cambio de ranking hace que los compradores compren más, no solo que puntúa mejor offline. Eso exige tres cosas que la mayoría de las demos se saltan: un modelo de ranking evaluado con juicios humanos y sin fugas de información, un motor de experimentación que llega a su propio veredicto y una línea clara entre lo que es real y lo que es simulado. SmartSearch es una versión completa e inspeccionable de ese ciclo: recuperar, ordenar, personalizar, registrar el comportamiento, probar, decidir y dejar que un agente de IA compre. Es un proyecto personal, no un trabajo para un cliente. El catálogo, las consultas y las valoraciones de relevancia proceden de WANDS, el conjunto de datos público de Wayfair, y el proyecto no está afiliado a Wayfair.
El producto en uso
Qué construí
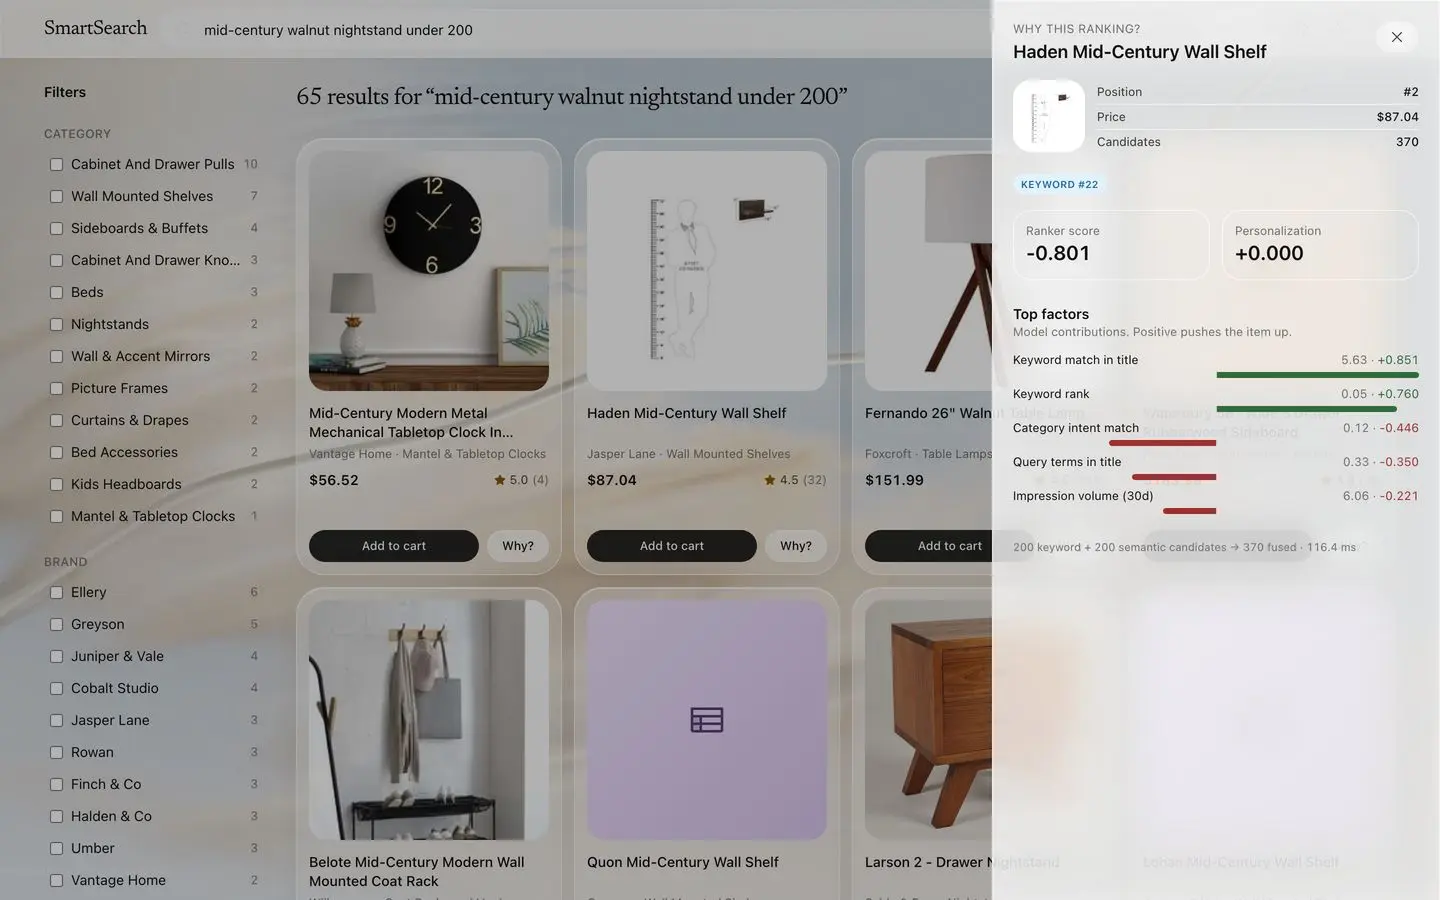
Búsqueda y ranking. De una consulta como «mid-century walnut nightstand under 200» se extraen el límite de precio y la categoría. BM25 y la búsqueda semántica devuelven 200 candidatos cada una, y la fusión por rango recíproco los une. Un modelo LightGBM LambdaRank entrenado con las 233.000 valoraciones humanas ordena la lista fusionada con 23 variables: puntuaciones y posiciones de recuperación, coincidencia de categoría, solapamiento con el título, precio, valoración, stock y tasas de comportamiento de los últimos 30 días. Un panel «Why this ranking?» en cada resultado muestra la puntuación del modelo, el término de personalización y las variables que más pesan, de modo que la relevancia se puede depurar en vez de adivinar.
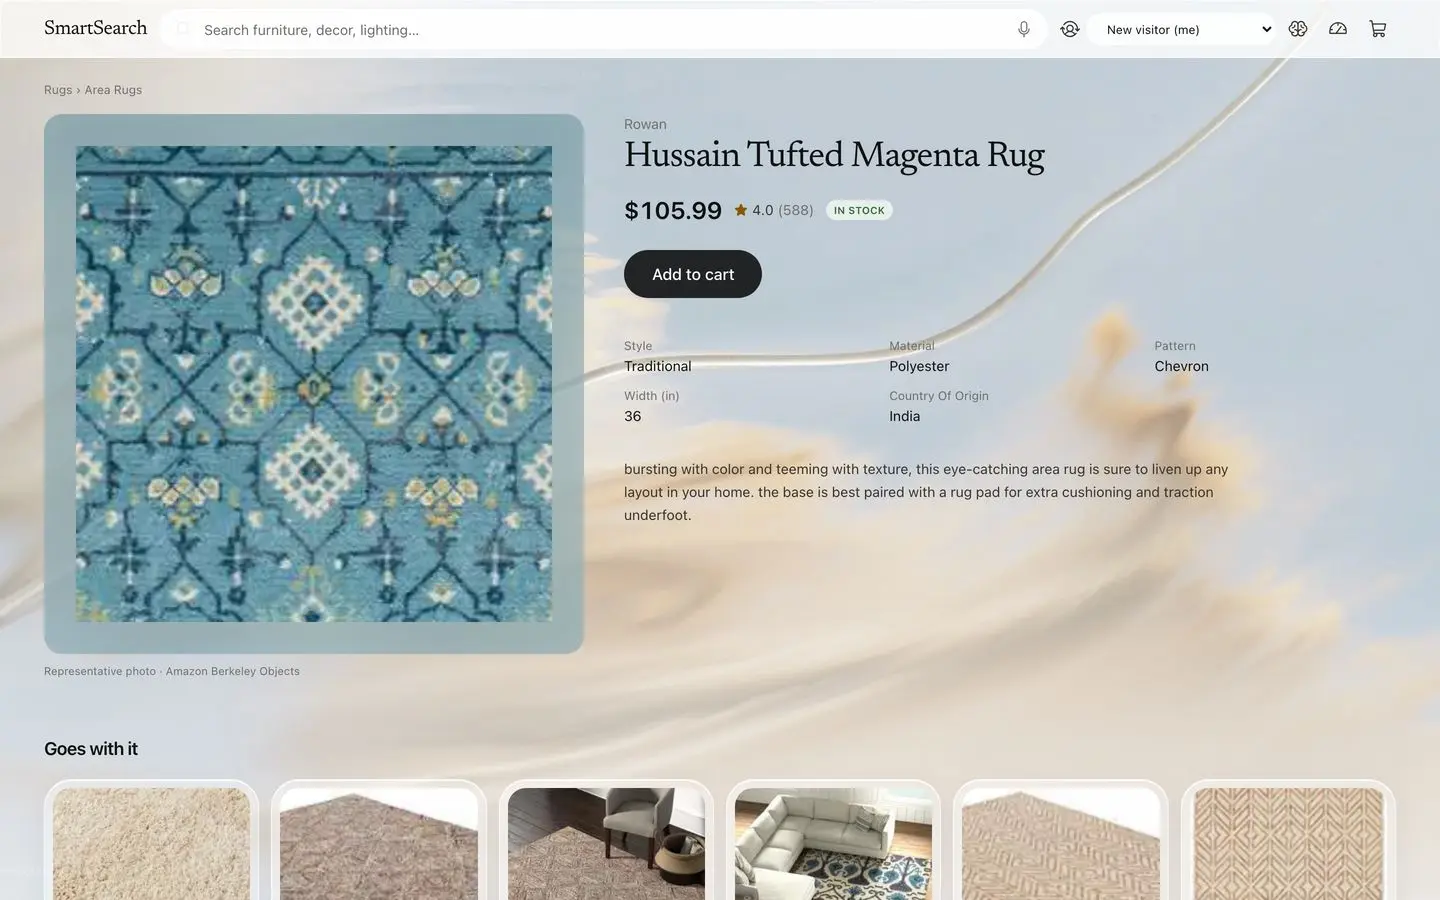
Personalización y recomendaciones. La personalización es un ajuste aditivo acotado entre −1 y 1, construido con el historial de marca, categoría, estilo, material, color y precio del comprador. Queda fuera del modelo, así que se puede apagar y probar por separado, y un comprador nuevo recibe cero. Las páginas de producto llevan tres tipos de recomendación: artículos similares a partir del espacio de embeddings, comprados juntos a partir de la similitud de compra conjunta y combina con a partir de un grafo de conocimiento de productos. Un hueco de exploración por muestreo de Thompson en la posición 5 da a los productos con menos de 50 impresiones la oportunidad de ser vistos.
Asistente de compra. Un bucle de uso de herramientas con Claude llama a las herramientas de búsqueda, recomendación y grafo de conocimiento de la propia tienda, y solo puede presentar productos que una herramienta haya devuelto. Extrae el presupuesto y las restricciones de la petición, da una razón de una línea para cada elección y añade al carrito cuando se le pide. Un saludo recibe una respuesta, no una búsqueda. Cada respuesta muestra una traza con el número de llamadas al modelo y el tiempo empleado.
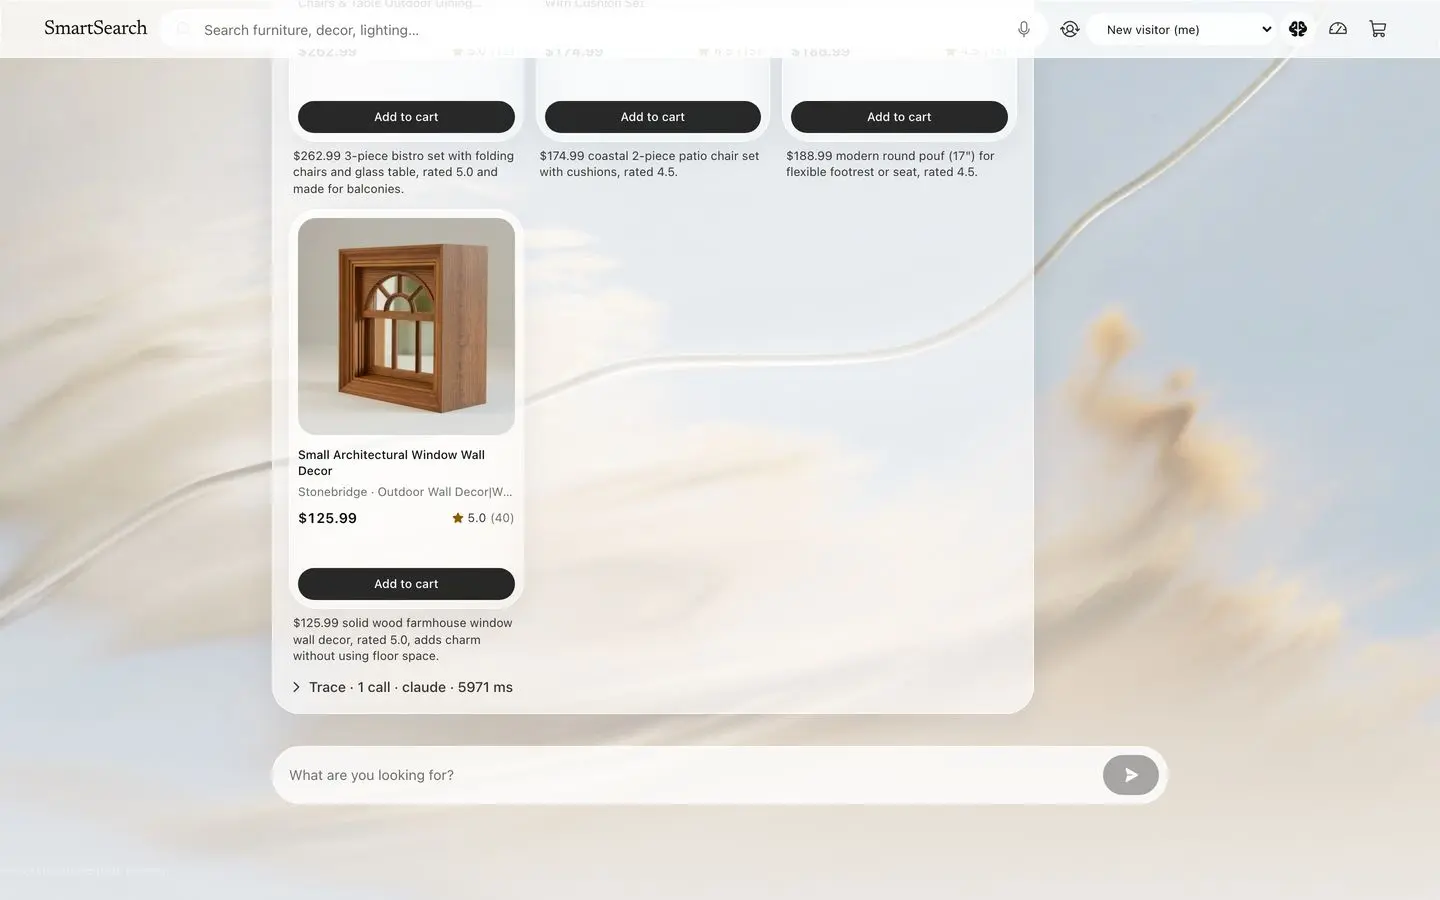
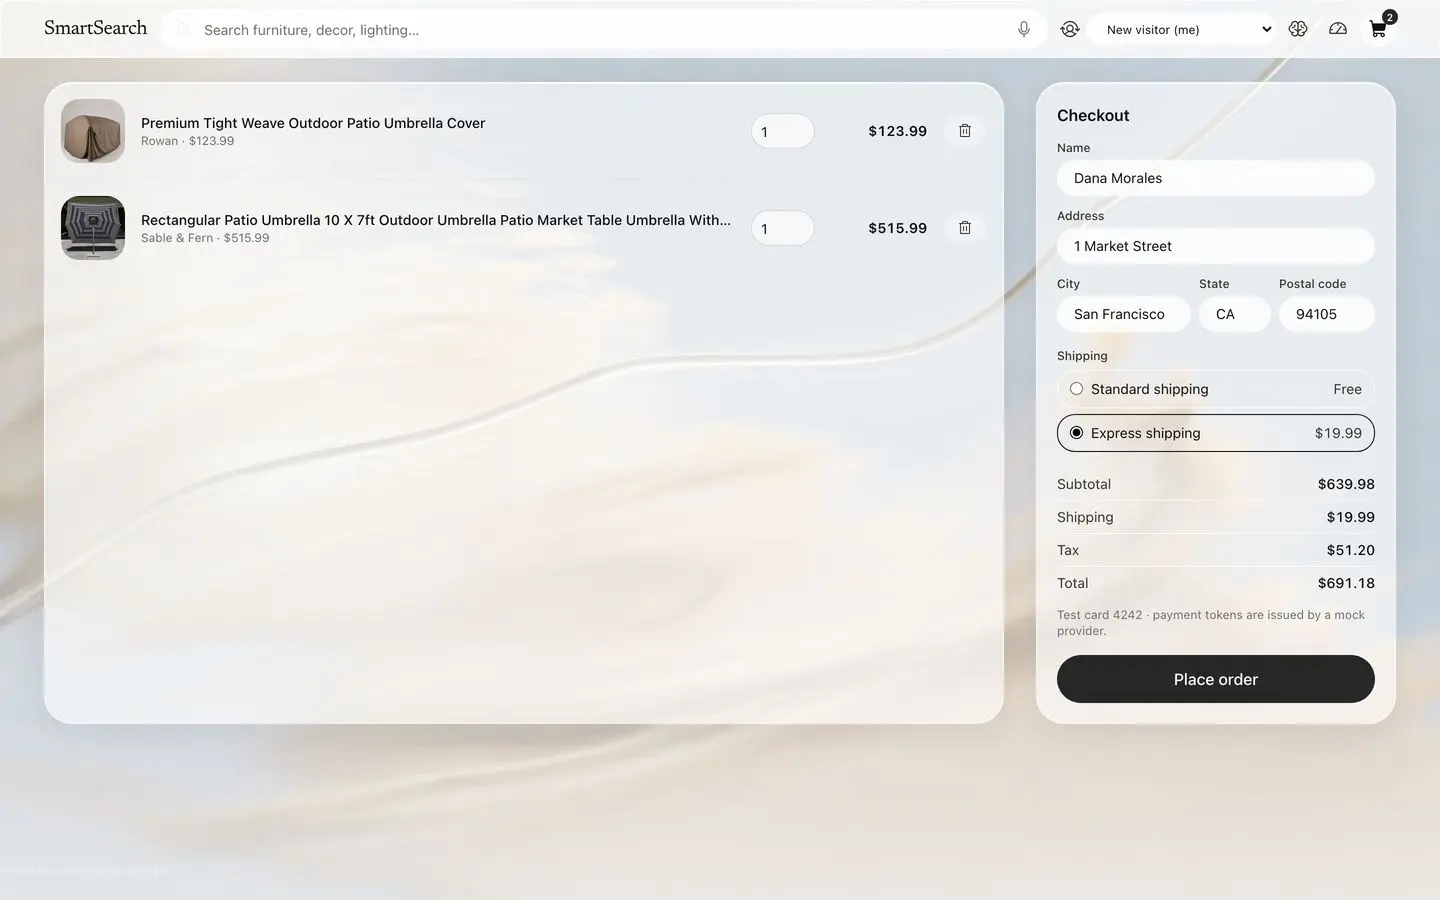
Pago para agentes. La tienda implementa el lado del comerciante del Agentic Commerce Protocol: sesiones de pago, un feed de productos y tokens de pago delegado. La página del carrito y el asistente son clientes de esos mismos endpoints, de modo que una sola implementación de pago sirve a personas y a agentes de IA, y los pedidos de los agentes acaban en el mismo registro de eventos y en los mismos experimentos que cualquier otra compra. El pago funciona con un proveedor simulado y solo con tarjetas de prueba.
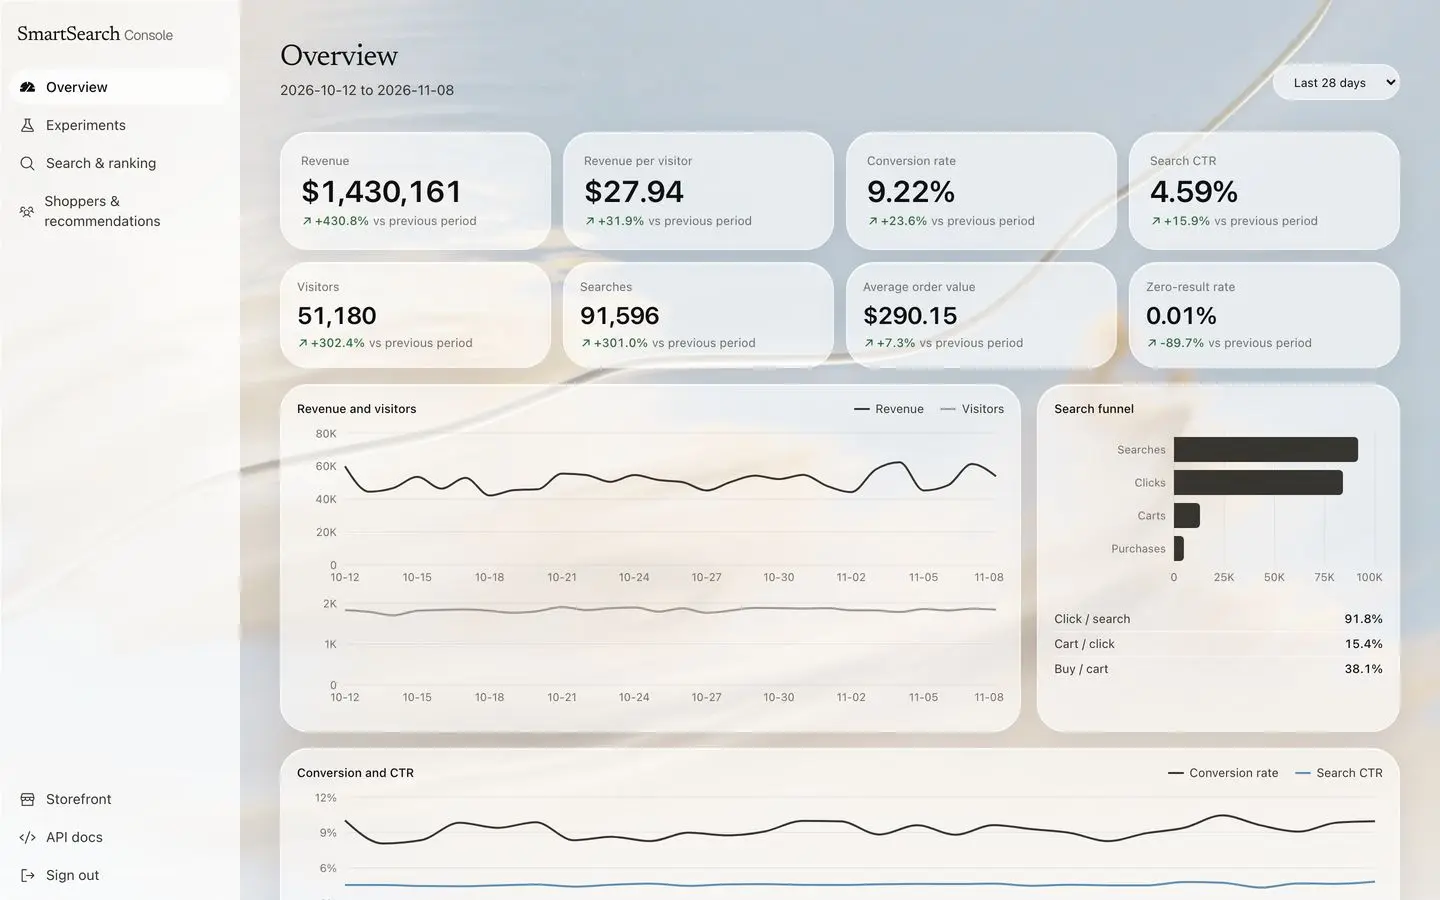
Consola del comerciante. Tras una palabra clave, la consola muestra ingresos, ingresos por visitante, conversión, CTR y tasa de búsquedas sin resultados con su variación frente al periodo anterior, el embudo de búsqueda, los términos de búsqueda con una curva de sesgo de posición, segmentos y cohortes, y una lista de ingresos en juego que ordena dónde pierde el embudo. Todo ello se lee de marts construidos sobre el registro de eventos simulado.
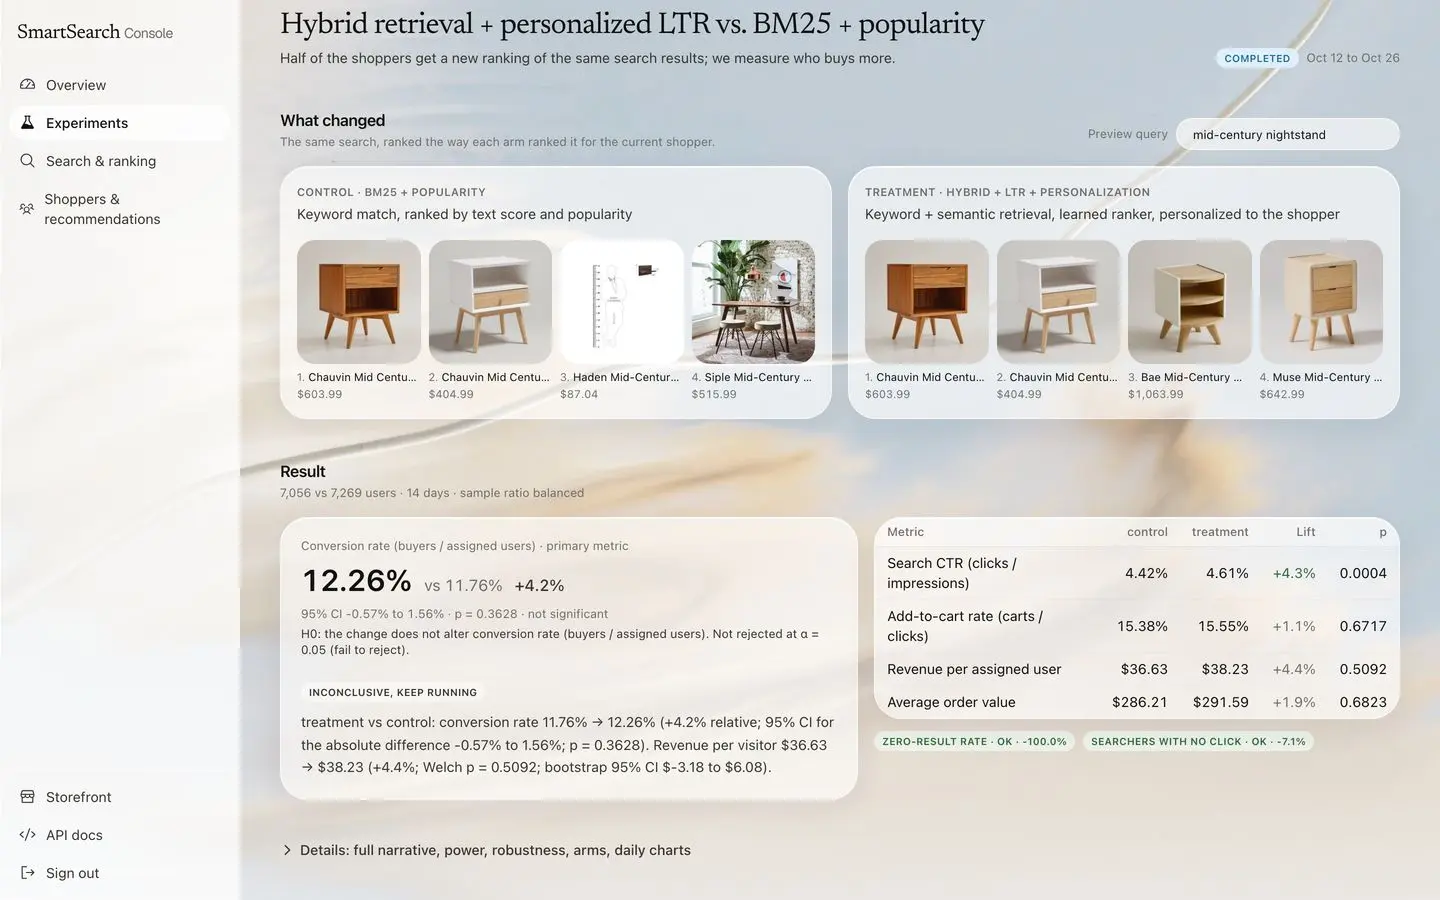
Experimentos con veredicto. Los compradores se reparten al 50/50 mediante un hash con sal y permanecen en su grupo, y cada comprador asignado sigue contando en el denominador. El informe muestra lo que enseña cada grupo para la misma consulta y después da control y tratamiento, el intervalo de confianza, el valor p y un veredicto claro. En el test principal ese veredicto es «no concluyente, seguir midiendo»: una conversión del 12,26 % frente al 11,76 % es un +4,2 % con p = 0,36, y detectar una mejora del 5 % exige unos 48.000 compradores por grupo, no 7.000.
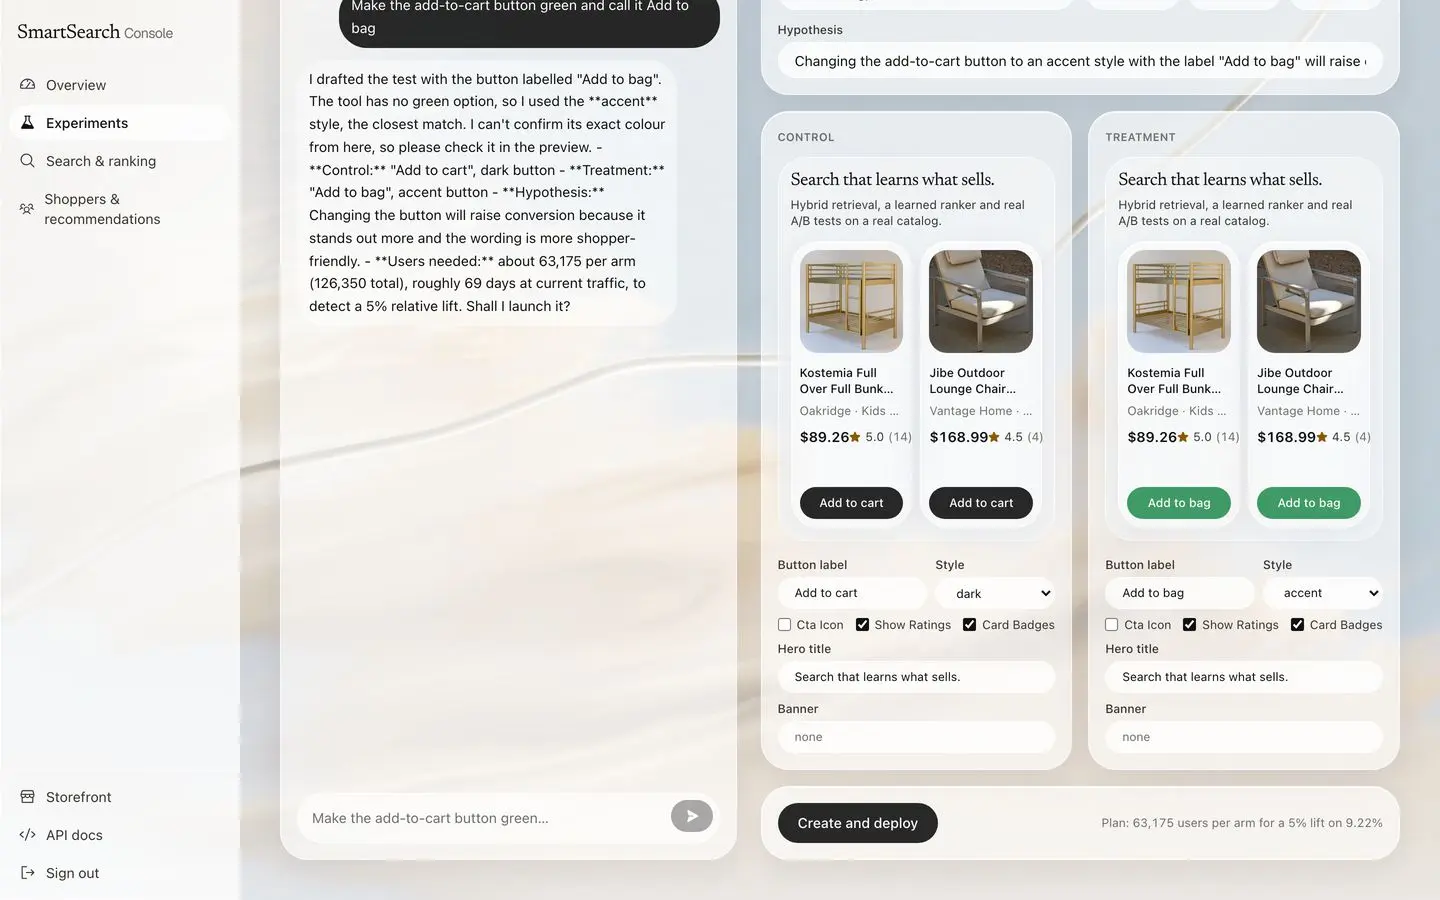
Un test a partir de una frase. En la consola, «Make the add-to-cart button green and call it Add to bag» se convierte en dos grupos con vista previa en vivo, una hipótesis y un plan de tamaño de muestra calculado sobre la línea base real. El asistente avisa cuando ha tenido que sustituir algo (la herramienta ofrece un estilo de acento, no una opción verde), y los resultados sobre tráfico simulado se etiquetan como simulados, con el efecto supuesto a la vista.
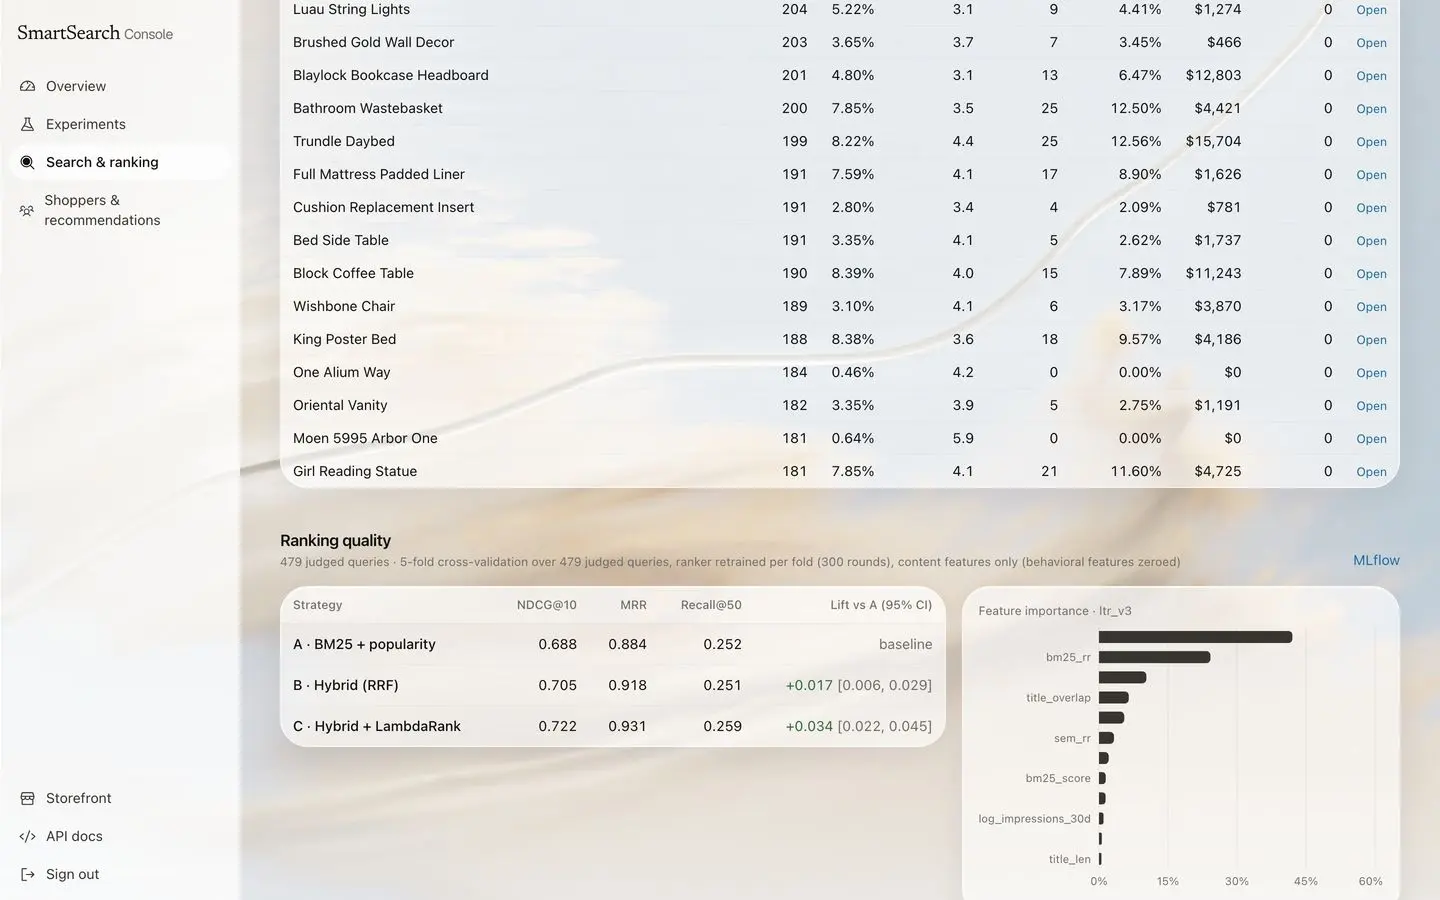
La calidad del ranking junto a los resultados online. La consola pone la tabla offline al lado de los experimentos: NDCG@10, MRR y Recall@50 por estrategia en validación cruzada de 5 particiones, con un intervalo de confianza del 95 % sobre la mejora, y la importancia de las variables del modelo campeón según el registro de MLflow. Una victoria offline aún tiene que superar el test A/B para lanzarse.
Cómo se juzga un resultado
Offline, las tres estrategias se comparan sobre 479 consultas valoradas con validación cruzada de 5 particiones, y el modelo se reentrena en cada partición. Las variables de comportamiento se congelan al final del periodo de calentamiento y se ponen a cero para la cifra principal. Antes de ese arreglo, una partición movió la línea base de 0,58 a 0,71 solo por clics filtrados. La recuperación híbrida añade +0,017 de NDCG@10 sobre BM25 (IC del 95 % de 0,006 a 0,029), y la recuperación híbrida con el modelo de ranking añade +0,034 (de 0,022 a 0,045). En las 96 consultas de prueba que nunca se buscaron durante el calentamiento, BM25 con un impulso de popularidad obtiene 0,584 frente a 0,729 de la lista fusionada.
Online, el motor empieza por una comprobación de la proporción de la muestra. Después vienen un test z de dos proporciones sobre la conversión, el test t de Welch y un bootstrap para los ingresos por visitante, el método delta para las métricas de ratio, CUPED, Benjamini–Hochberg sobre las métricas secundarias y un test secuencial para que mirar pronto no infle los falsos positivos, seguidos de la potencia y el efecto mínimo detectable. Un test A/A corre en paralelo para mostrar que la maquinaria no inventa mejoras (p = 0,07, nada significativo al 5 %). El hueco de exploración subió la tasa de añadido al carrito un 12 % (p = 0,001), con la conversión en +11 % y p = 0,08. Un bandit contextual que elige el ranking en cada petición parecía un 4 % mejor en la evaluación off-policy y después mostró un −6,2 % de conversión en vivo (p = 0,27); por eso se probó en vivo en vez de lanzarlo fiándose de la estimación.
Arquitectura
Una tienda y una consola en Next.js 15 hablan con un backend en FastAPI. El motor de ML corre dentro del proceso de la API: índices bm25s, embeddings de model2vec en una matriz en memoria, fusión de rangos, el modelo LightGBM, el ajuste de afinidad, el bandit, la similitud entre artículos y el grafo de conocimiento. PostgreSQL con pgvector guarda el catálogo, el registro de eventos de solo inserción y los marts SQL que lee la consola. Redis guarda en caché los perfiles de los compradores. MLflow mantiene el registro de modelos, y un modelo nuevo solo se promociona cuando su NDCG@10 en validación cruzada es al menos tan bueno como el del campeón. Un simulador genera 20.000 compradores a partir de seis perfiles y pasa cada búsqueda por el mismo código de ranking que la API, usando un modelo de clics con sesgo de posición calibrado con el clickstream público de Retailrocket. Una capa de decisión responde preguntas de opciones fijas (intención de la consulta, enrutado del asistente, un juez de relevancia) mediante Microsoft-Decision-1 o una alternativa local, así que el sistema funciona sin credenciales. Un solo make setup descarga los datos, construye los índices, entrena el modelo, ejecuta la simulación y escribe el informe de experimentos.
Qué es real y qué es simulado
Real: los 42.994 productos, las consultas y las 233.000 valoraciones de relevancia (WANDS), y las proporciones del embudo usadas para calibrar el simulador (Retailrocket). Simulado: todo el comportamiento de los compradores (20.000 perfiles, 2,6 millones de eventos en 35 días), además de los precios, las marcas y el stock, que son sintéticos y están marcados en los datos. Por tanto, los resultados A/B validan el pipeline y la estadística, no un caso de negocio, y la mejora de conversión no es significativa. Las fotos de producto son generadas a partir del texto del catálogo (166) o fotos representativas del conjunto Amazon Berkeley Objects emparejadas por similitud de texto (17.396), y ambos tipos se etiquetan en la página de producto. El pago usa un proveedor simulado. Los tests creados en la consola se leen sobre tráfico simulado con un efecto supuesto hasta que lleguen visitantes reales. El proyecto no está afiliado a Wayfair ni a Amazon.
Proyectos relacionados
Plataforma de análisis de parcelas con IA para una constructora
IA y agentes · Full-Stack y UI/UX · Ciencia de datos y ML
Clasificación sectorial de empresas (BERT + etiquetado con GPT-4)
Ciencia de datos y ML · IA y agentes
API REST en R y gráficos Plotly para una plataforma médica
Full-Stack y UI/UX · Ciencia de datos y ML