IA y agentes · Cloud, DevOps y LLMOps · Seguridad y cumplimiento
Azure AI Automation: documentos, RAG y agentes con aprobación humana
Por David Gadyan · Publicado el
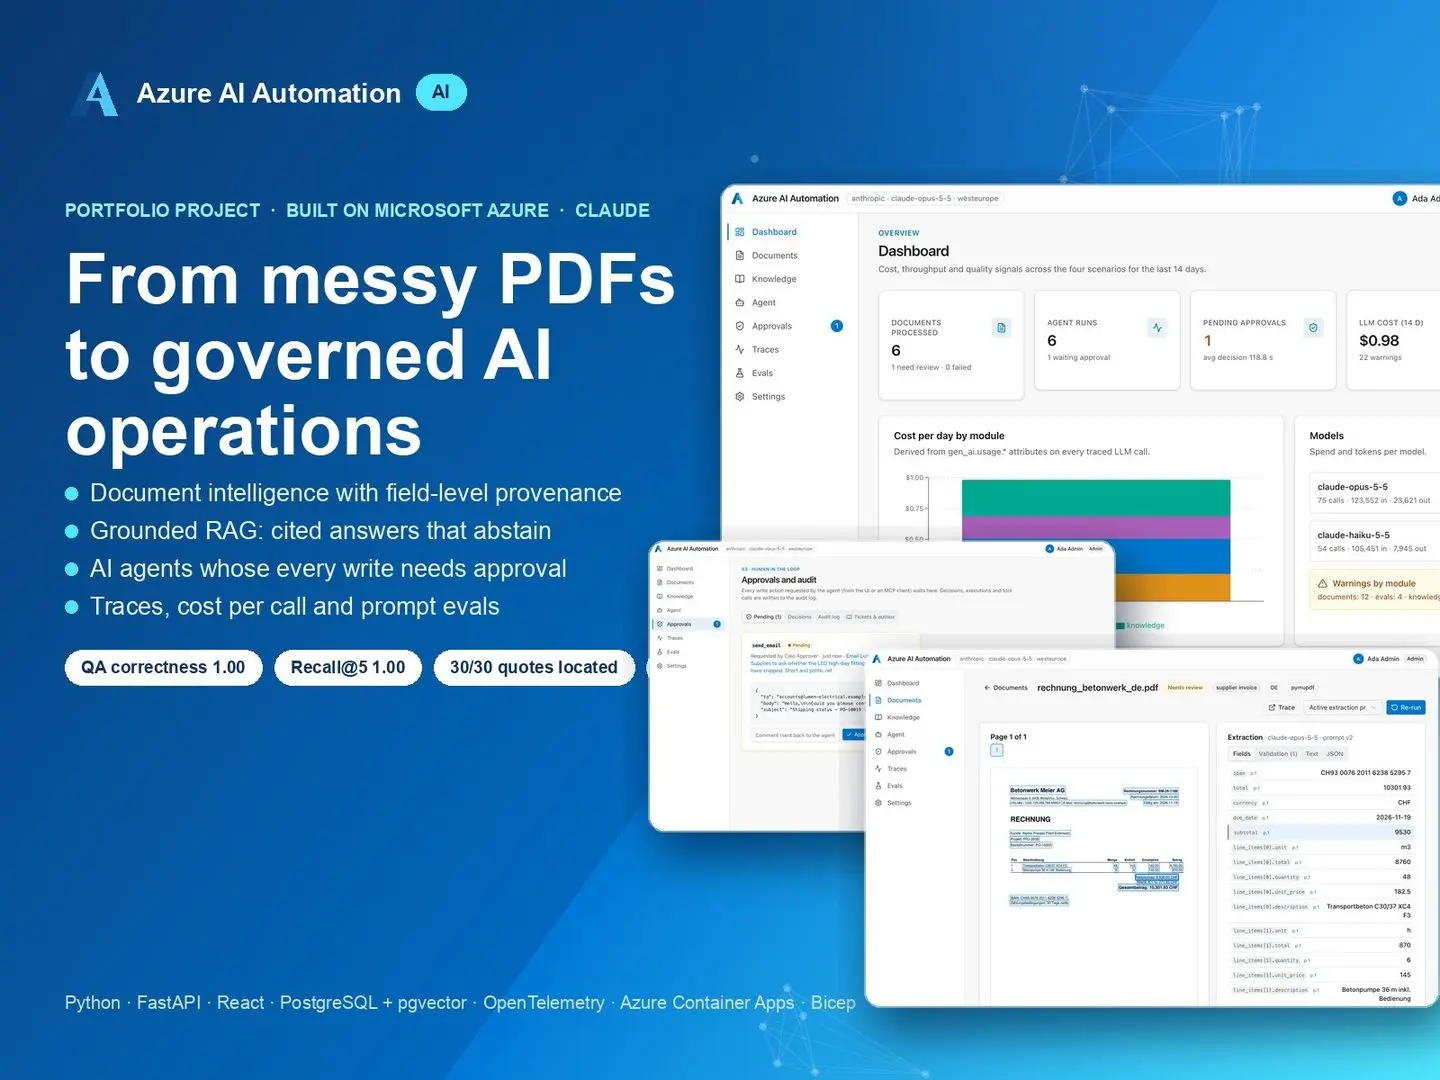
Plataforma Azure + LLM de principio a fin para el back office de construcción y fabricación. Convierte facturas, informes de inspección, certificados y planos (en inglés y alemán) en registros validados con una cita de origen por cada campo, responde a las preguntas del personal solo a partir de los documentos de la empresa, con citas y una abstención explícita, y ejecuta un agente con herramientas cuya acción de escritura siempre espera la aprobación de una persona. Cada llamada es una traza de OpenTelemetry con su coste, y las versiones de los prompts se miden sobre conjuntos de referencia. Funciona en local con Docker Compose y se despliega en Azure Container Apps con identidad administrada, Key Vault, almacenamiento Blob y Queue, PostgreSQL + pgvector y Application Insights.
El problema
Los equipos que conectan los servicios de IA de Azure con operaciones reales chocan siempre con los mismos muros: muchos servicios que orquestar (Document Intelligence, Blob, colas, búsqueda, el modelo), un estado que debe sobrevivir a pasos asíncronos y aprobaciones humanas, llamadas a herramientas que rompen el bucle del agente, requisitos de cumplimiento (RGPD, auditoría, identidad) y ninguna forma de saber si un cambio en un prompt mejoró o empeoró las respuestas. Este proyecto responde a cada uno de ellos con una sola aplicación desplegable, demostrada sobre los documentos que un back office de construcción o fabricación maneja a diario: facturas de proveedores, informes de inspección de obra, certificados de materiales y planos, en inglés y alemán.
El producto en uso
Qué construí
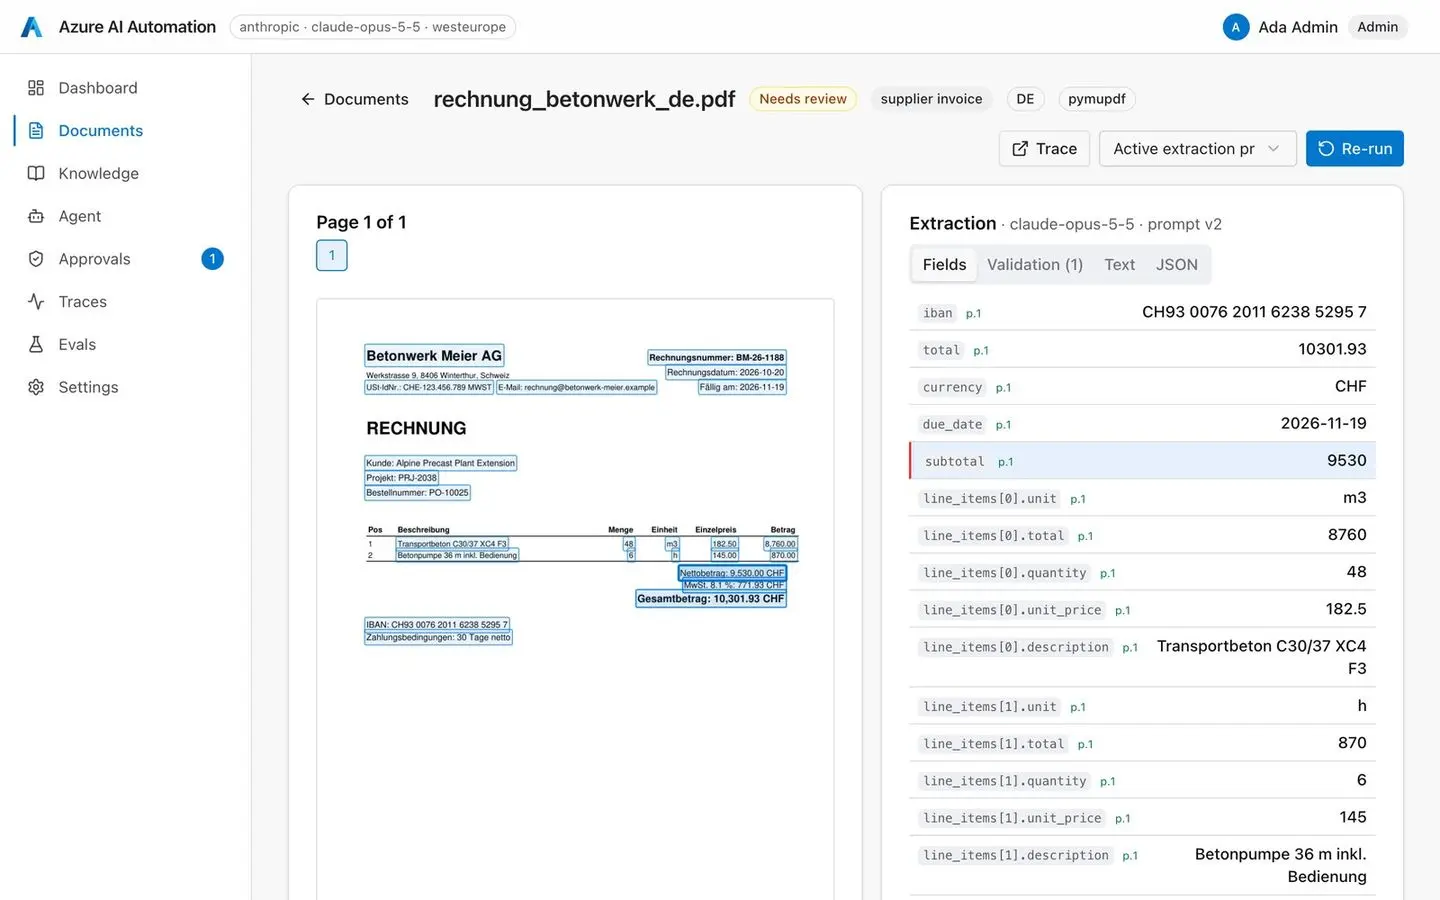
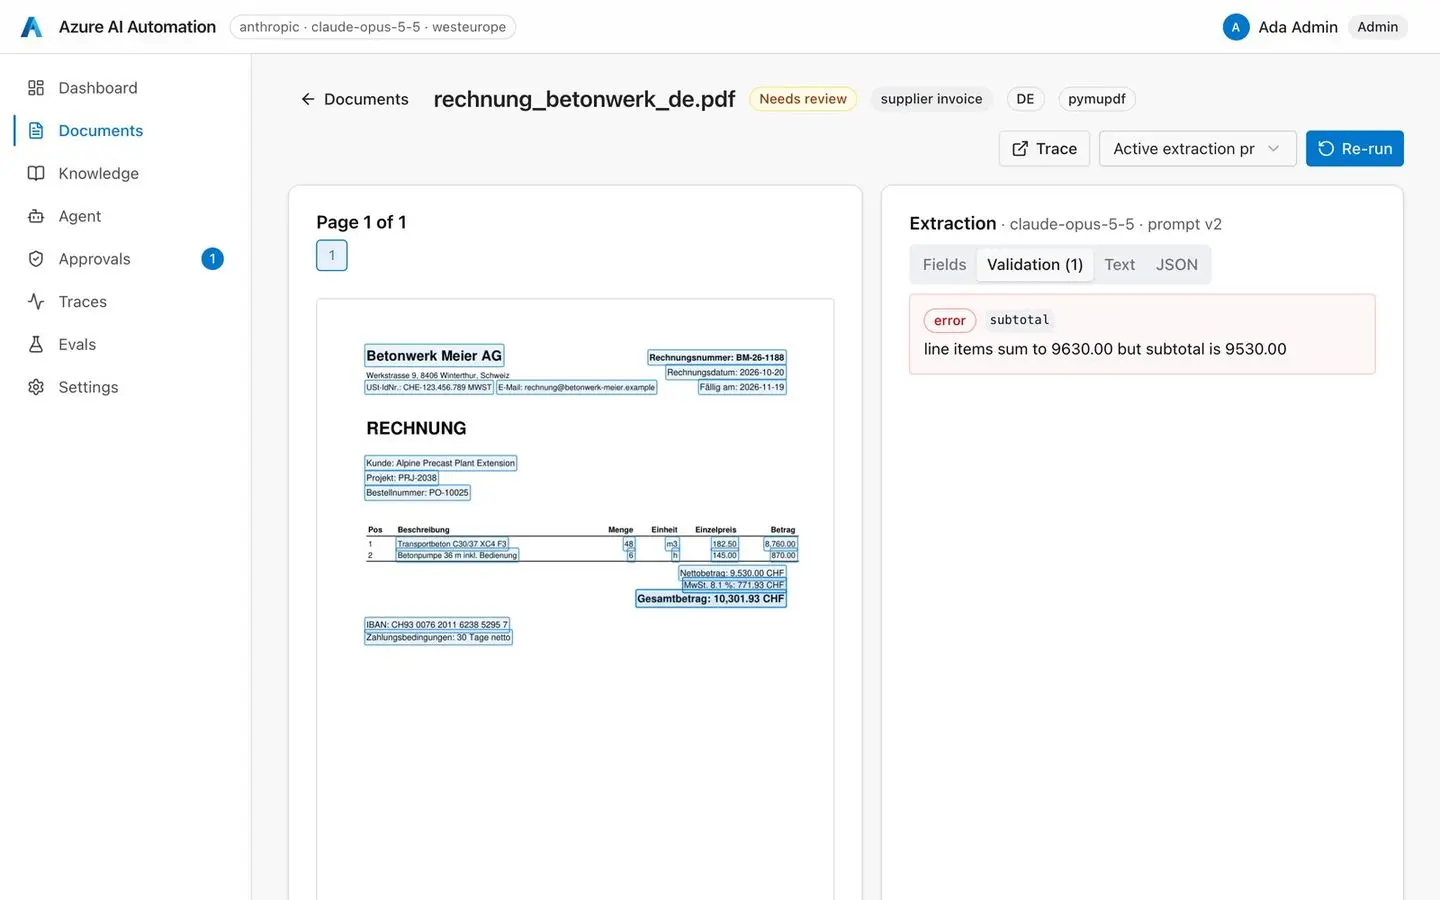
Inteligencia documental. Al subir un PDF, la canalización extrae las palabras con sus coordenadas (PyMuPDF, Azure AI Document Intelligence o la visión de Claude para escaneados), clasifica el documento, extrae un registro tipado con salidas estructuradas y cita el texto de origen exacto de cada campo, ligado a sus coordenadas en la página. Unas reglas deterministas validan totales, fechas y la lógica entre campos: una factura alemana cuyas líneas no suman el importe neto impreso se marca para revisión en lugar de contabilizarse. Las versiones de los prompts se pueden volver a ejecutar sobre el mismo documento y comparar.
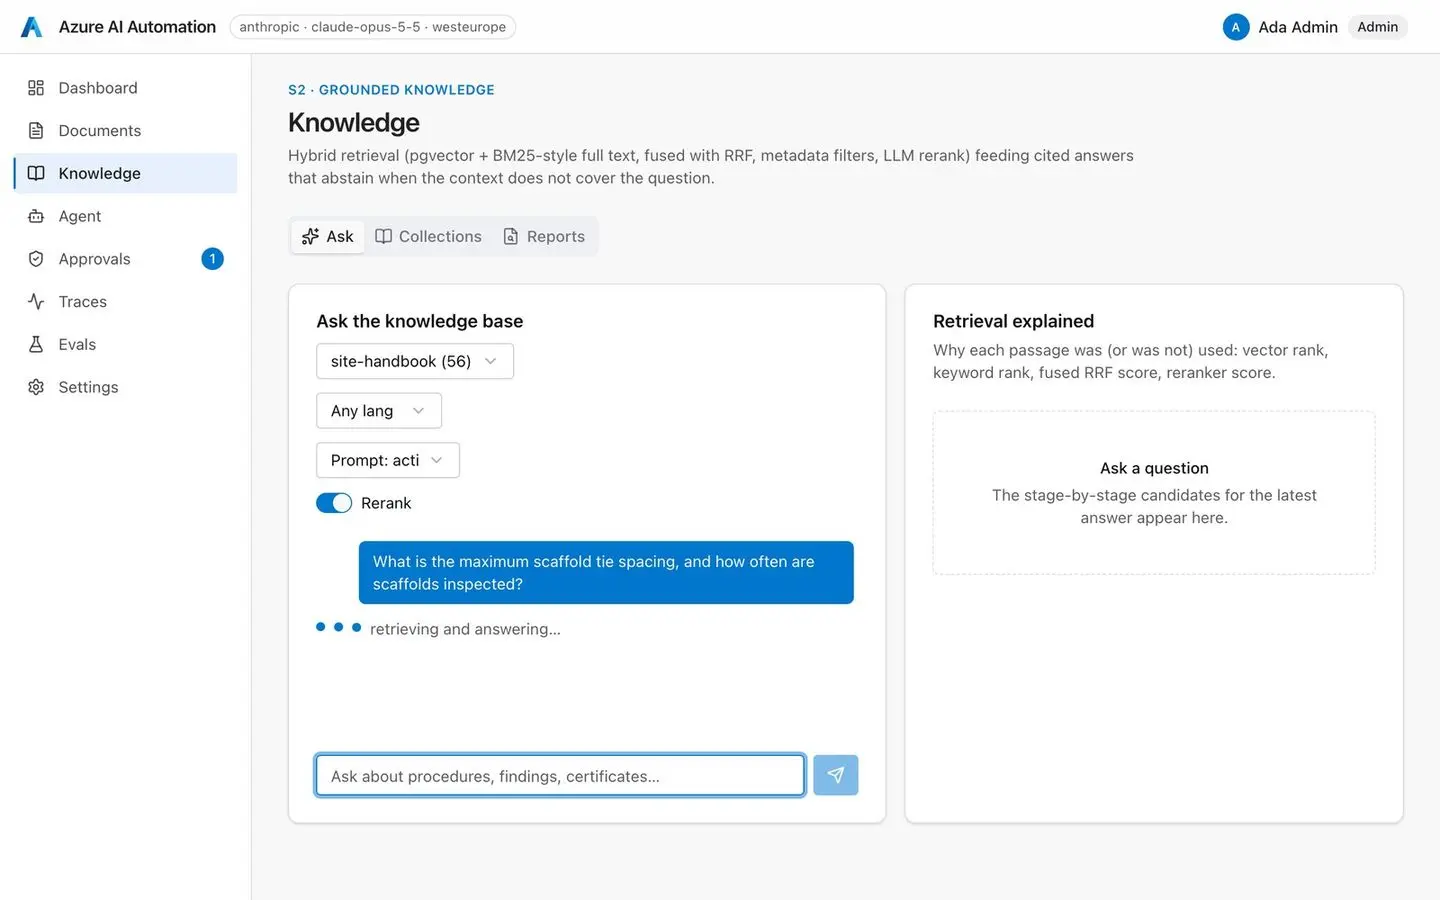
Base de conocimiento con fundamento. Los manuales y los documentos procesados se indexan en PostgreSQL + pgvector. Las preguntas se responden con recuperación híbrida (búsqueda vectorial y por palabras clave fusionadas con RRF, filtros de metadatos y reordenación con LLM), citas numeradas que abren el pasaje de origen y una abstención explícita de «contexto insuficiente» cuando los documentos no cubren la pregunta. Un panel de «recuperación explicada» muestra la posición vectorial, la posición por palabras clave, la puntuación fusionada y la del reordenador de cada pasaje candidato. Los informes combinan redacción fija aprobada con secciones redactadas por la IA y citadas, y necesitan aprobación antes de generar la exportación a Word.
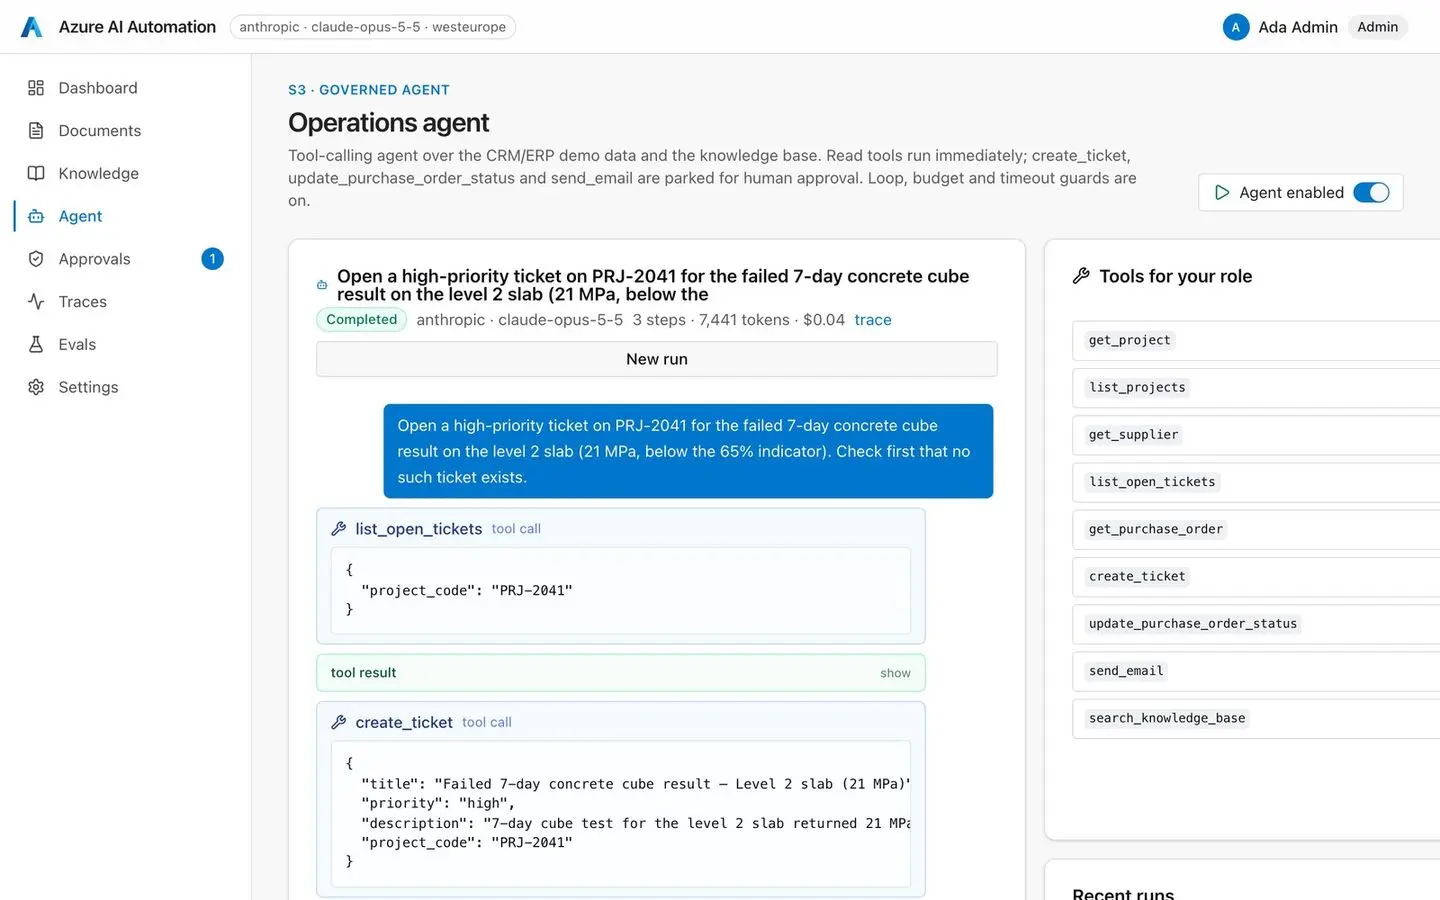
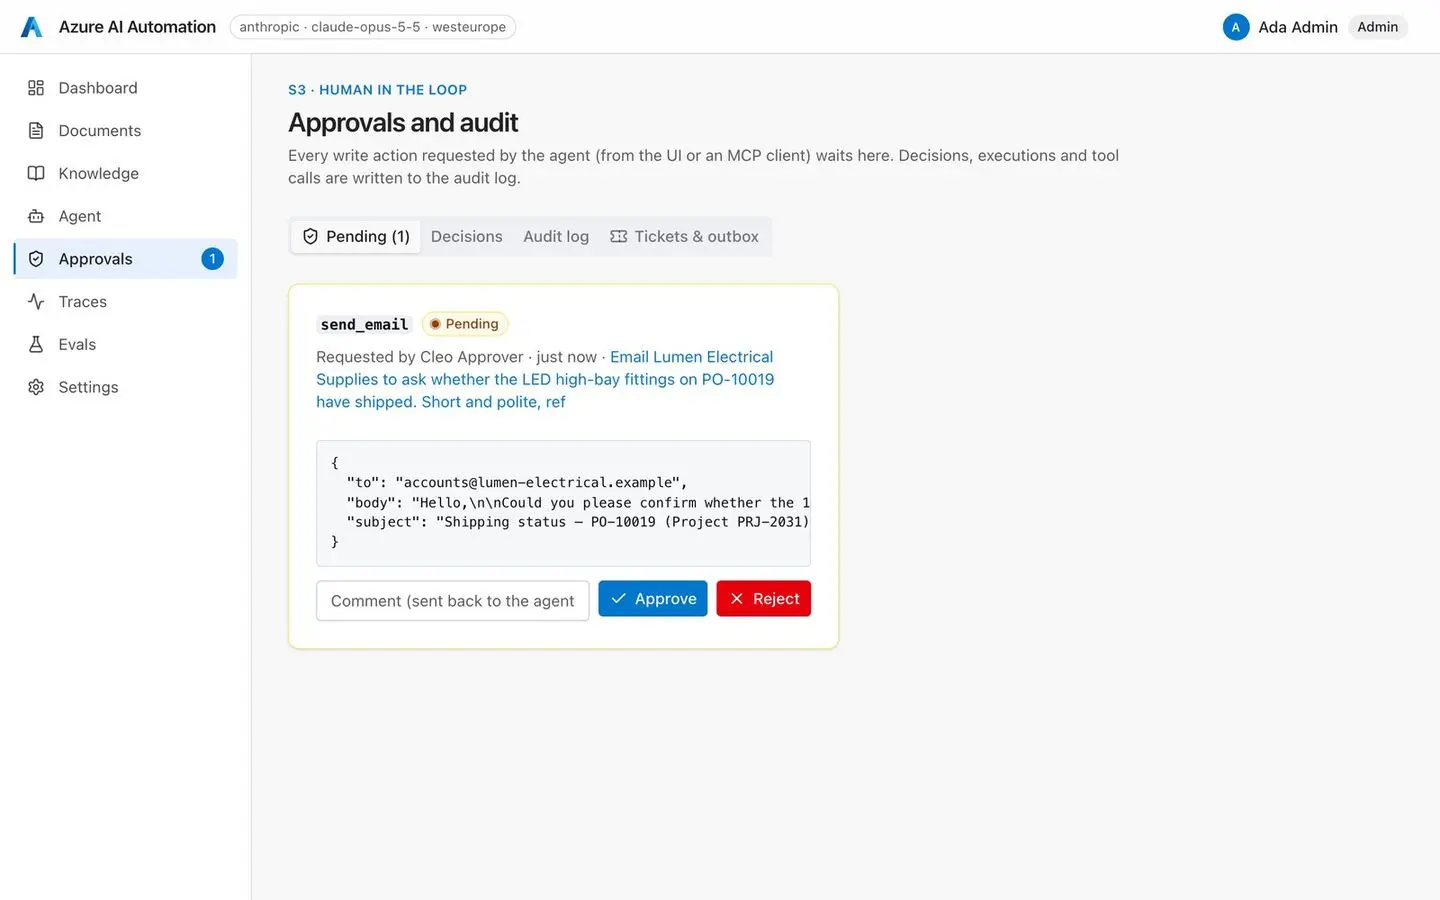
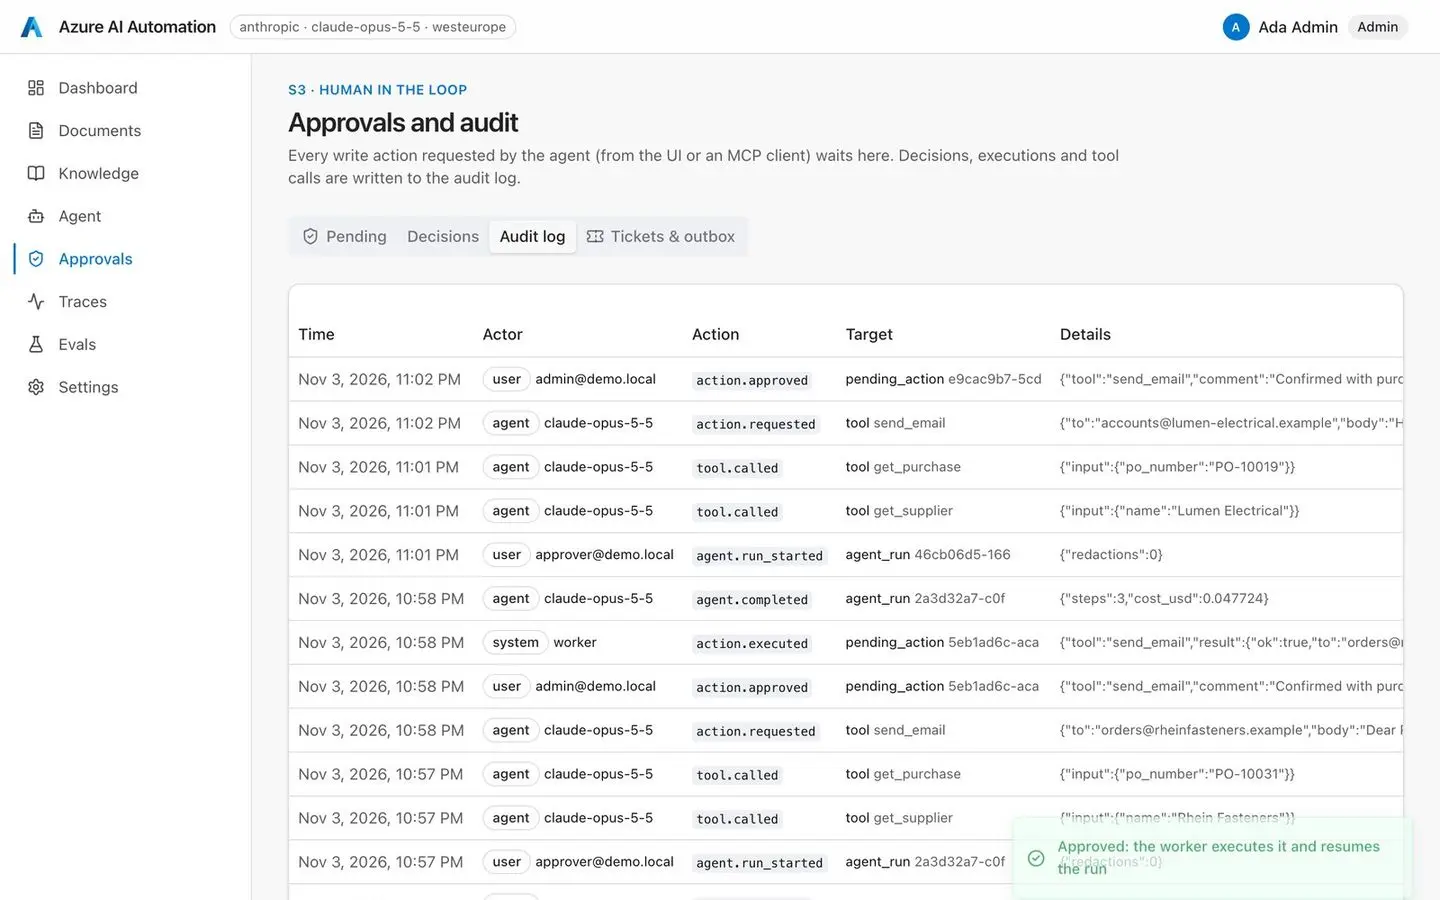
Agente gobernado. Un agente con herramientas consulta proyectos, proveedores, pedidos de compra e incidencias y busca en la base de conocimiento. Las herramientas de lectura se ejecutan al momento; crear una incidencia, cambiar un pedido o escribir a un proveedor queda en espera de una persona que lo apruebe, y el worker ejecuta las acciones aprobadas y reanuda la ejecución, horas o reinicios después, dentro de la misma traza. Permisos por rol para cada herramienta, detección de bucles, presupuestos de tokens, tiempos máximos por herramienta, higiene frente a la inyección de prompts, un interruptor de emergencia y un registro de auditoría completo. Las mismas herramientas se exponen por MCP, de modo que Claude Desktop o Claude Code pueden usarlas con las mismas aprobaciones.
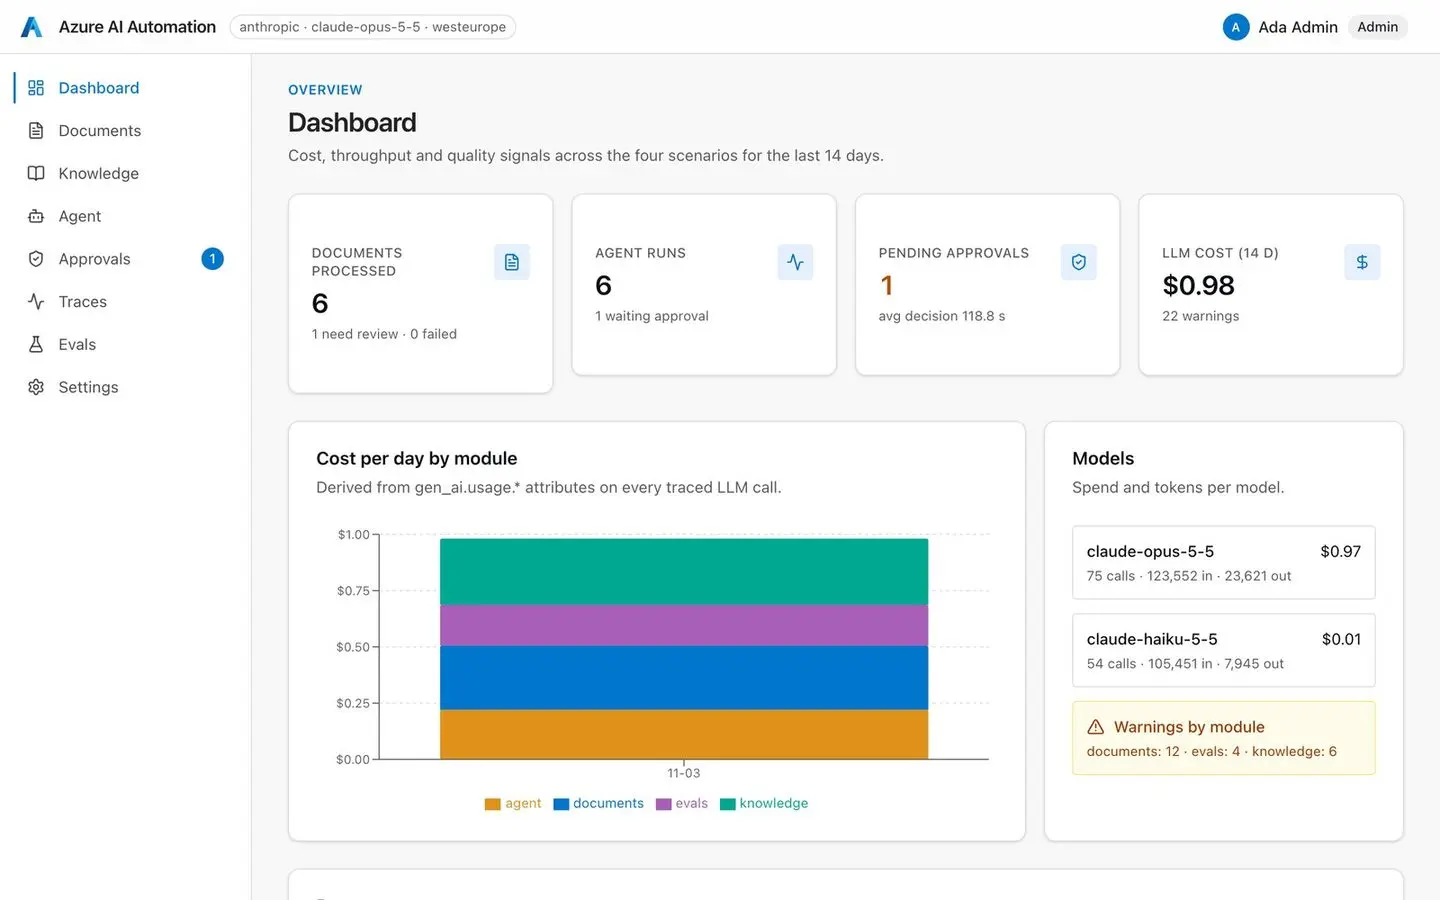
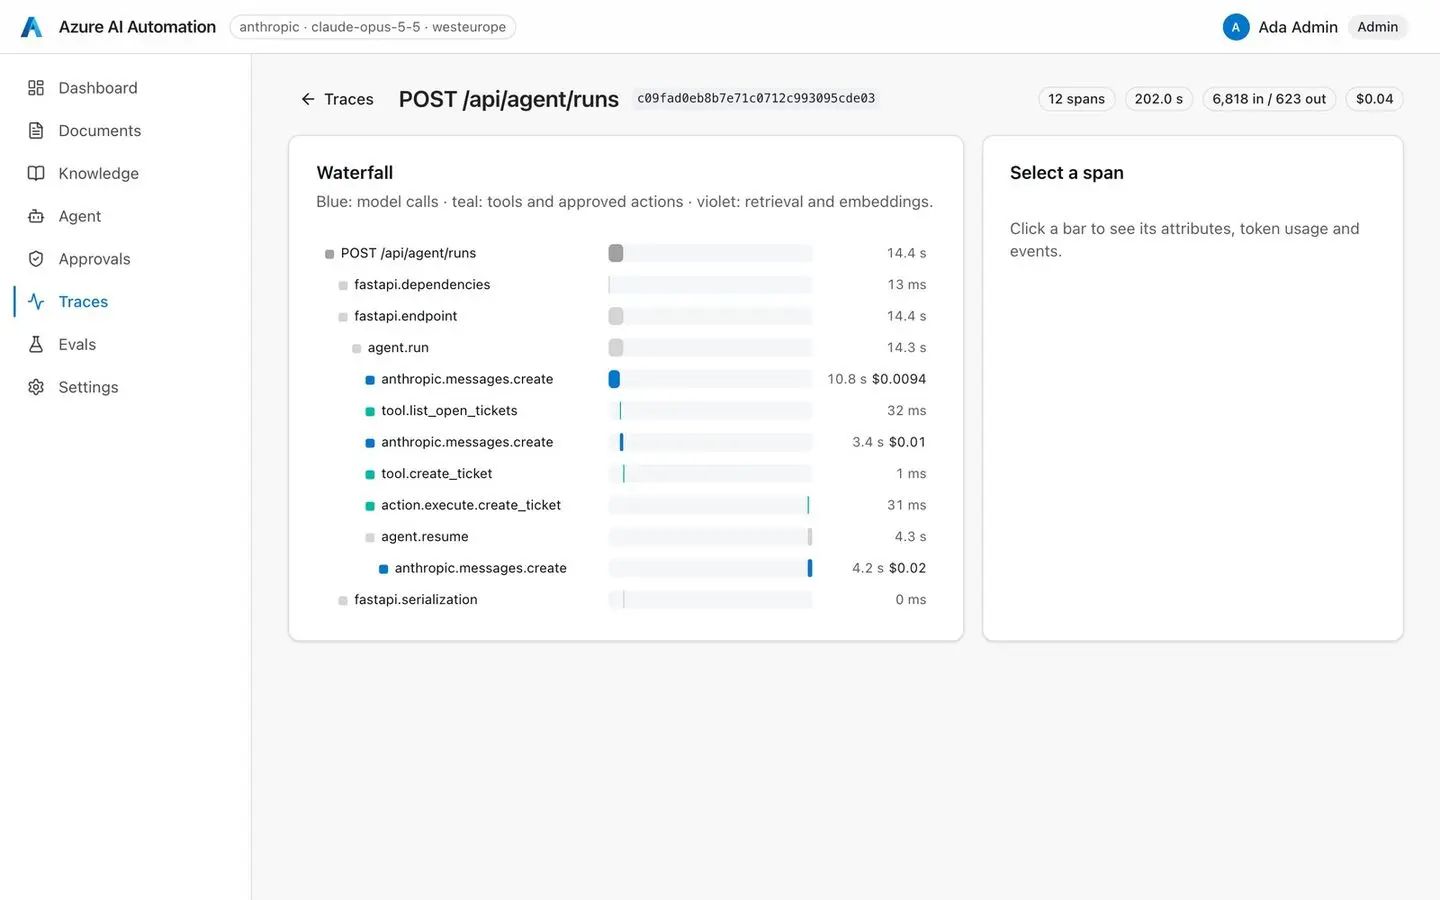
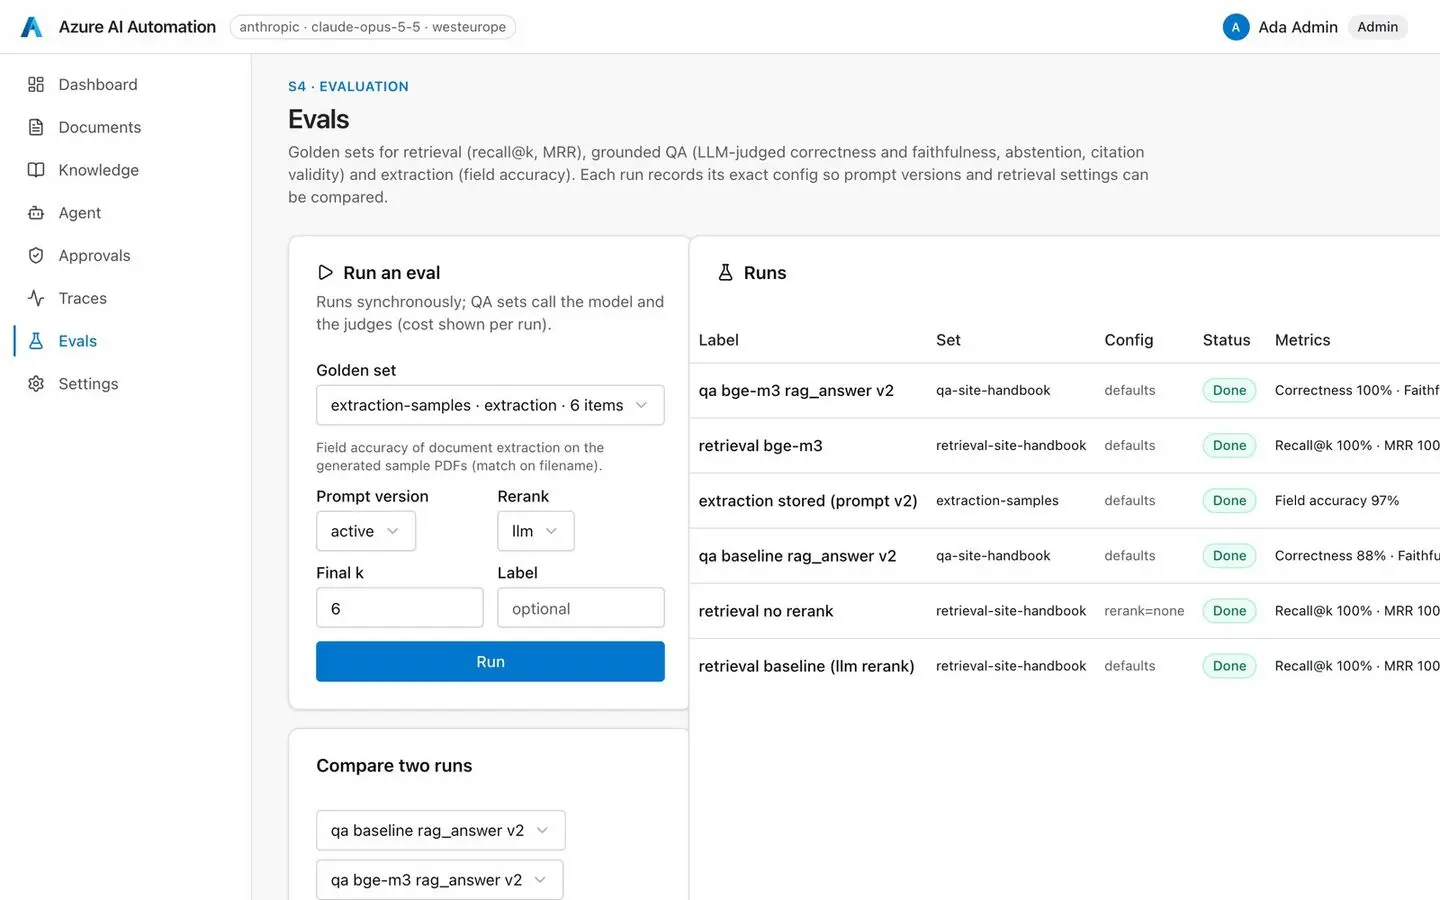
Observabilidad y evaluación. Cada procesamiento de documento, cada respuesta y cada ejecución del agente es una traza de OpenTelemetry con los tokens y el coste de cada llamada al modelo, visible en la aplicación o en Application Insights. Los prompts están versionados y se cambian en tiempo de ejecución. Los conjuntos de referencia miden el recall y el MRR de la recuperación, la corrección y la fidelidad de las respuestas (jueces LLM), la abstención y la precisión por campo de la extracción, y dos ejecuciones se comparan lado a lado, así que los cambios se deciden con números y no con impresiones.
Qué encontraron las evals
La pregunta en inglés «¿Qué calificación activa un plan de mejora para un proveedor?» solo la responde la página en alemán de evaluación de proveedores. Con un modelo de embeddings centrado en el inglés, la búsqueda vectorial nunca la recuperaba y el sistema se abstenía correctamente; al cambiar al modelo multilingüe bge-m3, la corrección de QA y la precisión de la abstención pasaron de 0,875 a 1,00. Ese es el tipo de decisión (modelo de embeddings, troceado, umbral de reordenación) que la vista de evals existe para hacer visible en lugar de dar por supuesta.
Arquitectura
API en FastAPI y worker de cola, interfaz en React, PostgreSQL + pgvector, almacenamiento Blob y Queue de Azure (Azurite en local), Claude mediante el SDK de Anthropic con una alternativa autoalojada en Ollama, Azure AI Document Intelligence como opción, OpenTelemetry hacia Postgres y Application Insights, y Bicep para Container Apps, Key Vault, Storage, PostgreSQL Flexible Server, Document Intelligence y Log Analytics. Todo lo específico de Azure está detrás de un proveedor con un valor local por defecto, de modo que la pila completa corre en un portátil con un solo docker compose up, y el mismo código se despliega en Azure Container Apps con una identidad administrada asignada por el usuario.
Cómo responde a los problemas habituales
- Muchos servicios de Azure que encajar. Una interfaz de proveedor para cada cosa: LLM, embeddings, Blob, Queue y Document Intelligence; la canalización los orquesta con reintentos, idempotencia por sha256 y una cola de mensajes envenenados.
- Estado a lo largo de un flujo distribuido. Las transcripciones del agente se guardan con la forma de bloques de contenido de Anthropic; una ejecución se pausa para la aprobación y se reanuda con los resultados de herramienta preparados, en la misma traza.
- Fiabilidad de las llamadas a herramientas. Esquemas JSON estrictos a partir de Pydantic, comprobación de permisos en el servidor, tiempos máximos, errores de herramienta devueltos al modelo en lugar de romper el bucle, un detector de bucles y un presupuesto de tokens.
- Autenticación y cumplimiento. Roles y JWT en local; identidad administrada, Key Vault y RBAC en Bicep; redacción de datos personales antes de las llamadas a LLM externos; una vía de borrado para el derecho de supresión; región de la UE por defecto; registro de auditoría de cada acción.
- Control de alucinaciones. Respuestas solo a partir de pasajes numerados, comprobación de la validez de las citas, un marcador de abstención, fidelidad juzgada por LLM en las evals y citas de procedencia para cada campo extraído.
- Observabilidad y calidad de los prompts. Exportadores de spans a Postgres y Application Insights, coste a partir de los atributos de uso de gen_ai, prompts versionados y conjuntos de referencia comparados ejecución contra ejecución.
Proyectos relacionados
Private AI Gateway: acceso seguro y autoalojado a LLM para cada equipo
IA y agentes · Seguridad y cumplimiento · Cloud, DevOps y LLMOps
AI Jobs MCP: servidor MCP remoto con Google OAuth en AWS Lambda
IA y agentes · Cloud, DevOps y LLMOps · Seguridad y cumplimiento
CareLens: IA clínica en Kubernetes y Azure, lista para HIPAA
Cloud, DevOps y LLMOps · Seguridad y cumplimiento · IA y agentes