IA y agentes · Seguridad y cumplimiento · Cloud, DevOps y LLMOps
Private AI Gateway: acceso seguro y autoalojado a LLM para cada equipo
Por David Gadyan · Publicado el
Un gateway de IA autoalojado por el que pasan todas las aplicaciones y agentes de IA de la empresa para llegar a un modelo. Las claves de los proveedores se guardan en una bóveda OpenBao y cada equipo solo puede abrir la suya. Los presupuestos y límites de uso cortan el gasto al llegar al tope. Los guardarraíles enmascaran datos personales y bloquean secretos filtrados e inyecciones de prompts. Cada llamada se registra por equipo para repercutir costes, y las aplicaciones siguen usando el SDK de OpenAI mientras los modelos cambian detrás de alias estables. LiteLLM OSS con plugins propios, FastAPI, una consola Next.js con SSO de Keycloak, Docker y Helm, 44 tests. Una segunda versión aplica las mismas ideas en AWS con Bedrock AgentCore Gateway, políticas Cedar y seguridad a nivel de fila en Postgres.
El problema
Cada equipo había contratado su propia cuenta de IA. Las claves de API estaban en el código y en los chats, nadie conocía la factura total hasta que llegaba, y la plantilla pegaba correos y números de tarjeta de clientes en los prompts. Cambiar a un modelo más barato o mejor obligaba a tocar cada aplicación. La solución es un único gateway por el que pasan todas las aplicaciones y agentes de IA: guarda las claves, limita el gasto, revisa lo que sale y registra cada llamada. Este gateway funciona en los servidores de la propia empresa o en su propia cuenta en la nube, y una segunda versión muestra los mismos controles con servicios gestionados de AWS.
El producto en uso
Qué construí
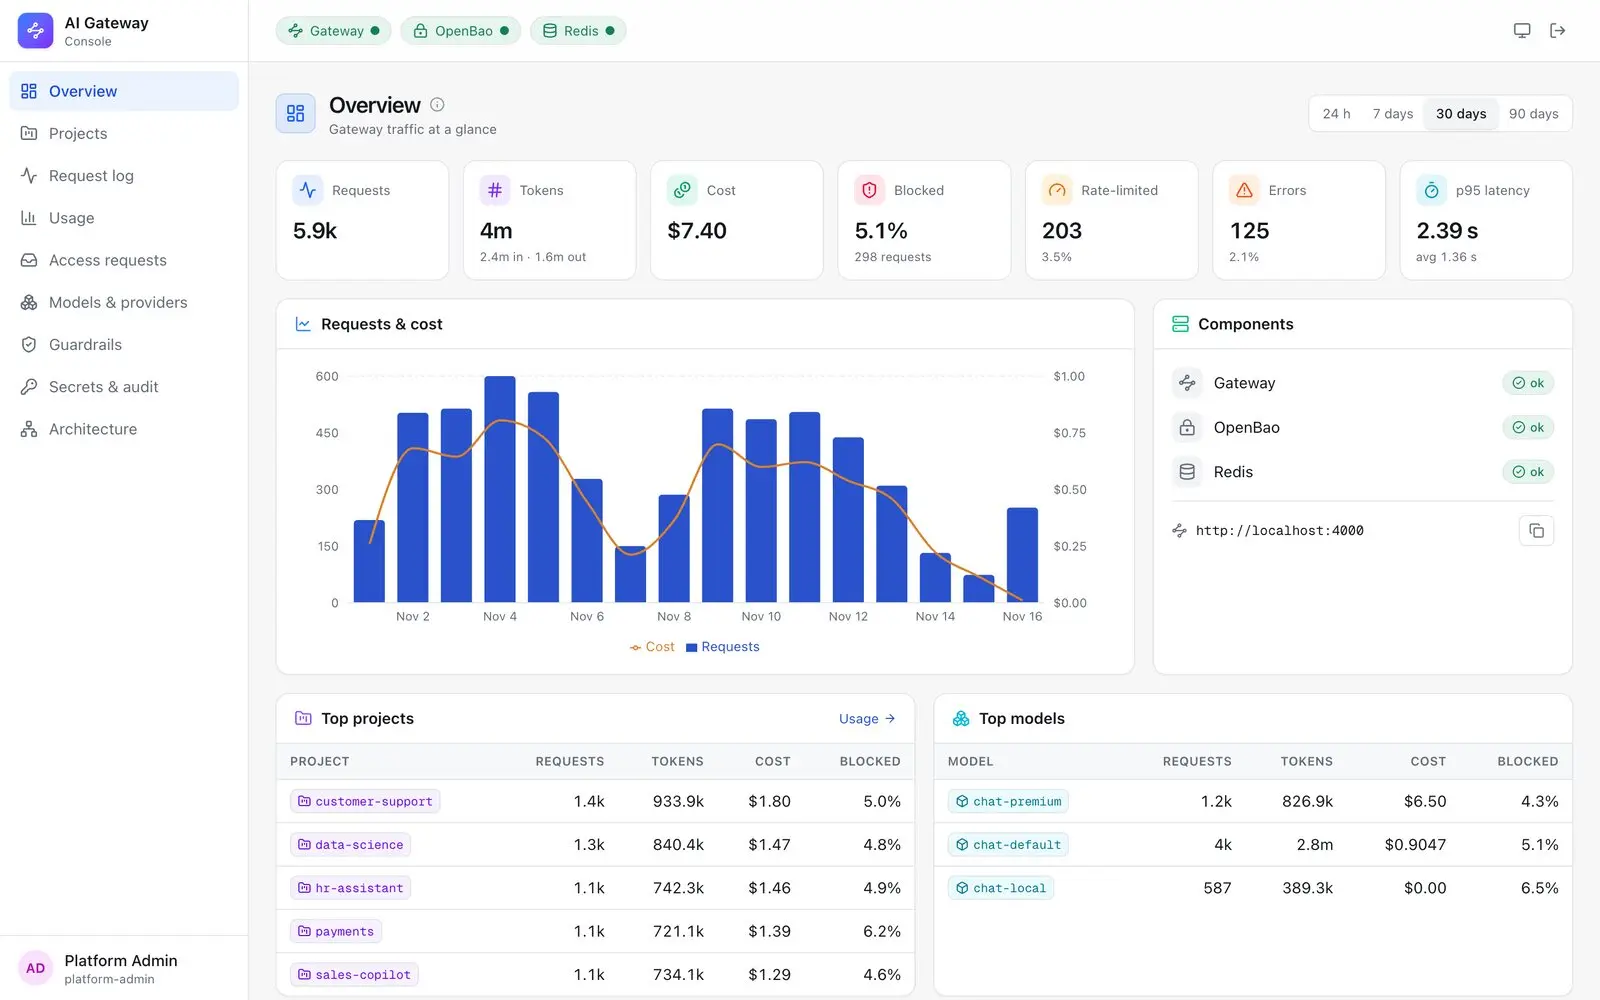
Una sola puerta con su panel. El panel general muestra peticiones, tokens, coste, porcentaje de bloqueos, llamadas limitadas, errores y latencia p95 del periodo elegido, un gráfico diario de peticiones y coste, los proyectos y modelos que más gastan y el estado del gateway, la bóveda y Redis. La pregunta "¿cuánto gastamos en IA y en qué?" tiene respuesta en tiempo real.
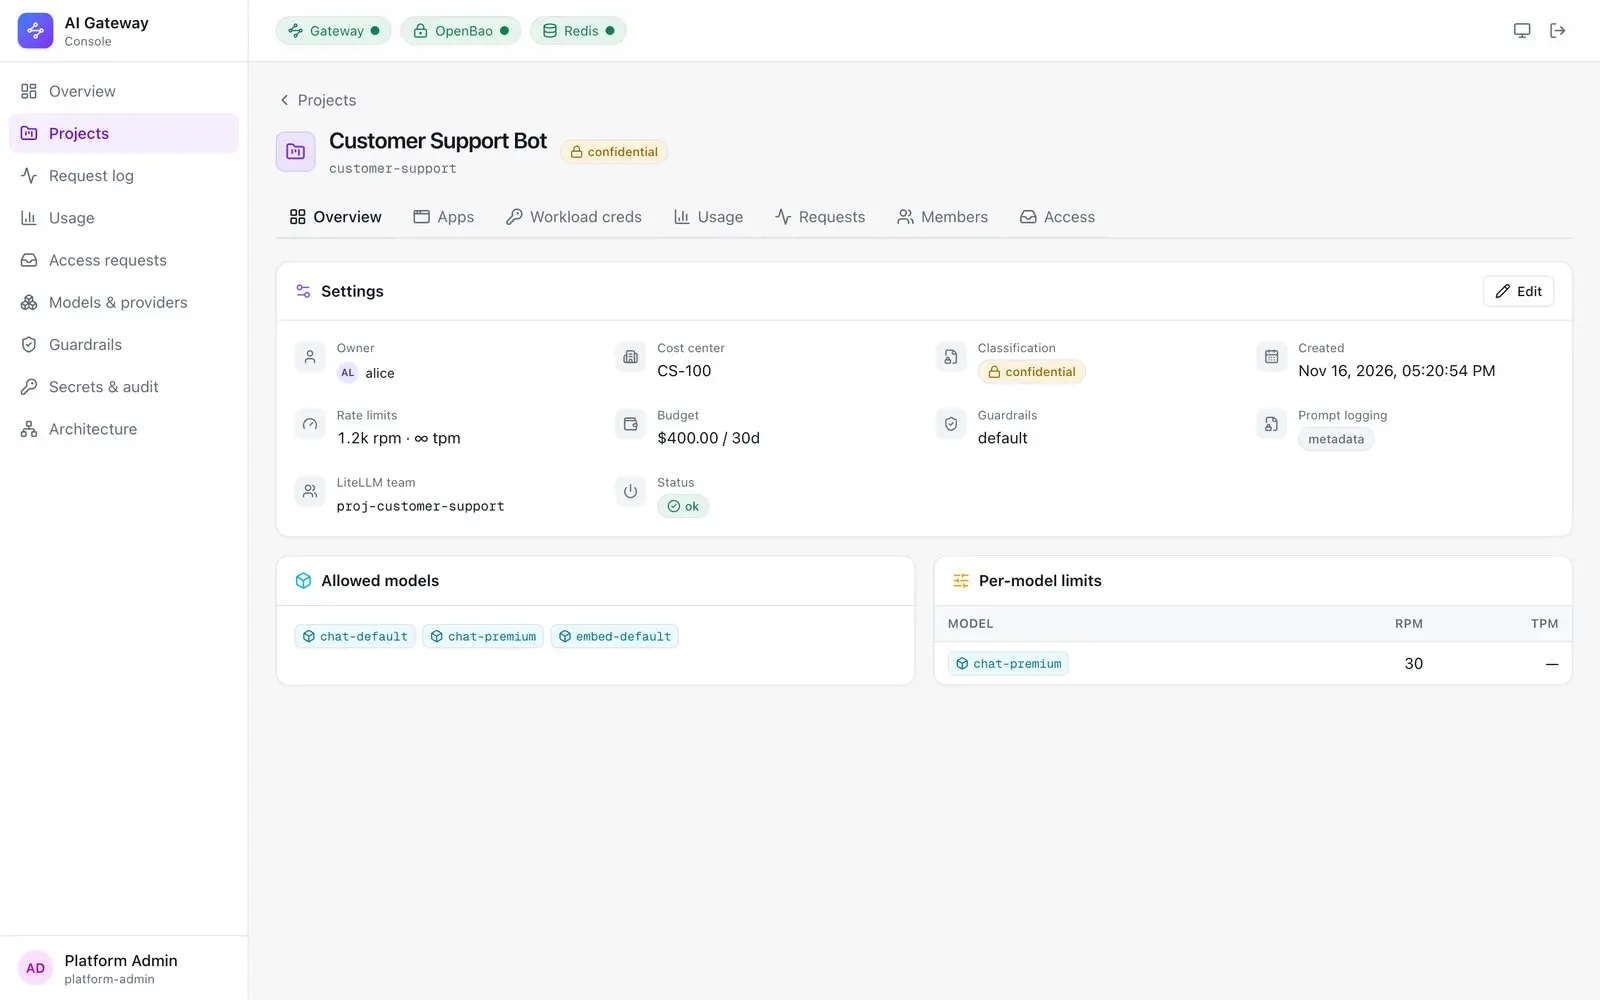
Presupuestos y límites por equipo. Cada equipo es un proyecto con responsable, centro de coste y clasificación de datos. Tiene un límite de peticiones, un presupuesto por periodo, una lista de modelos permitidos y límites por modelo. En la captura, el bot de soporte puede hacer 1,2k peticiones por minuto, gastar 400 $ cada 30 días y llamar al modelo premium solo 30 veces por minuto.
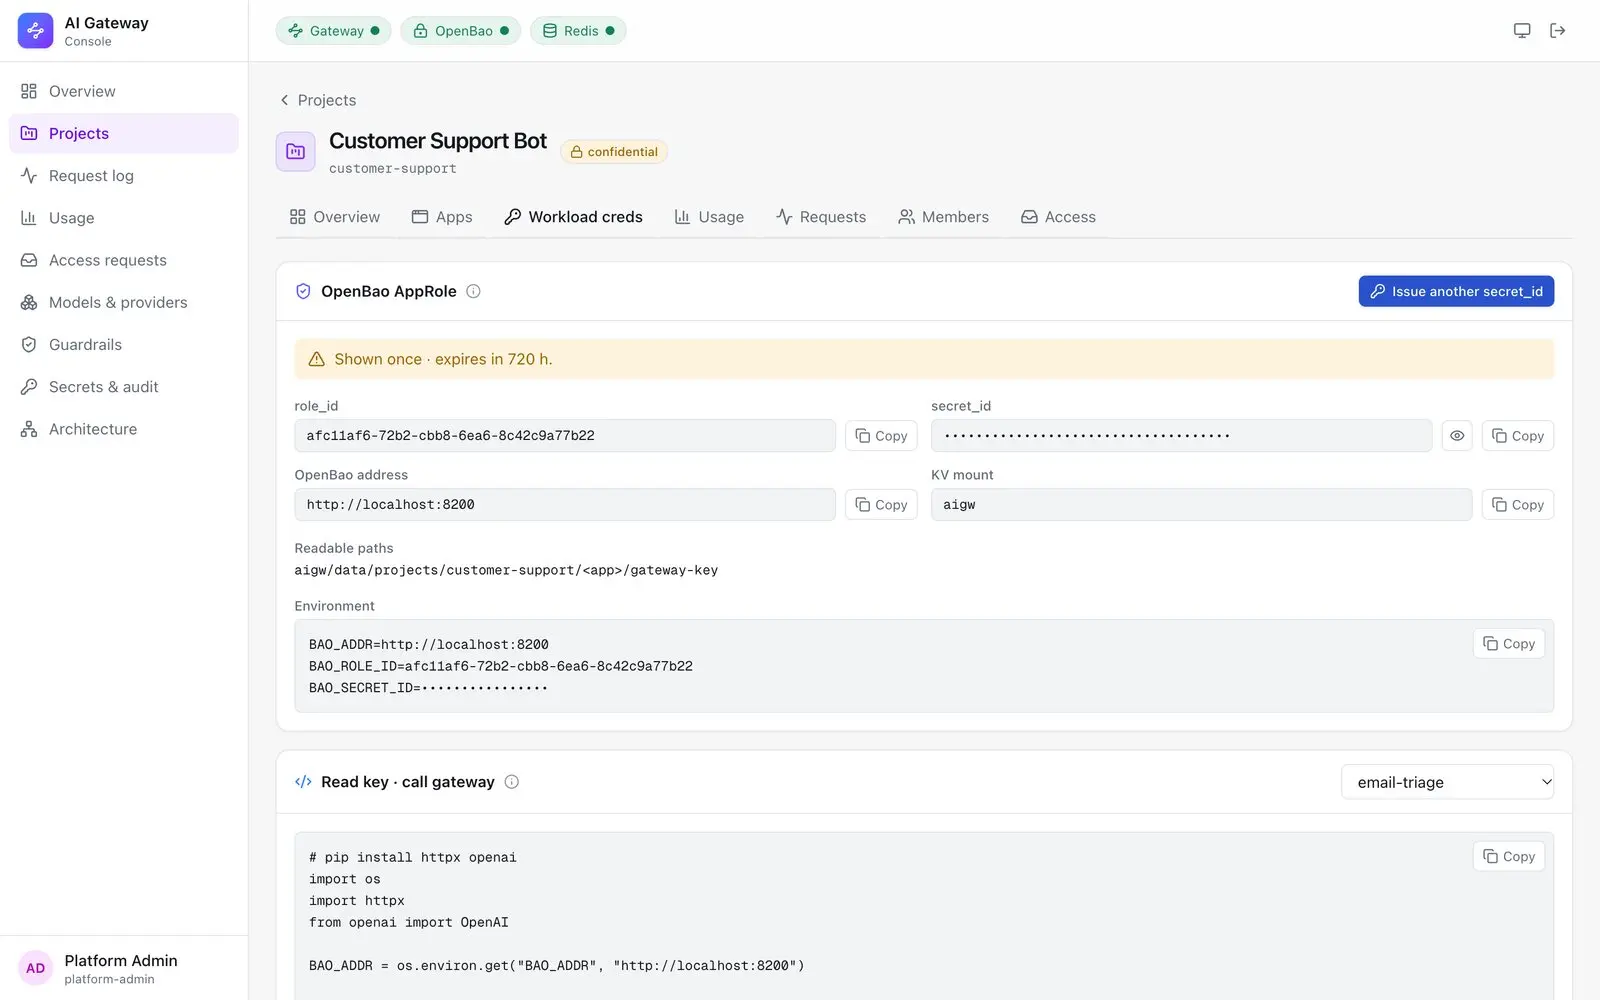
Claves en una bóveda, una puerta por equipo. Las claves de los proveedores (OpenAI, Anthropic y otros) solo viven en OpenBao, el fork de código abierto de Vault. La consola entrega a cada proyecto su propio acceso a la bóveda, que se muestra una sola vez y es válido durante 720 horas. Con él, las aplicaciones del equipo solo pueden leer su propia clave del gateway dentro de la ruta del proyecto; cualquier otra ruta devuelve 403. Una nueva clave de proveedor se rota en todos los procesos del gateway en marcha sin reiniciar.
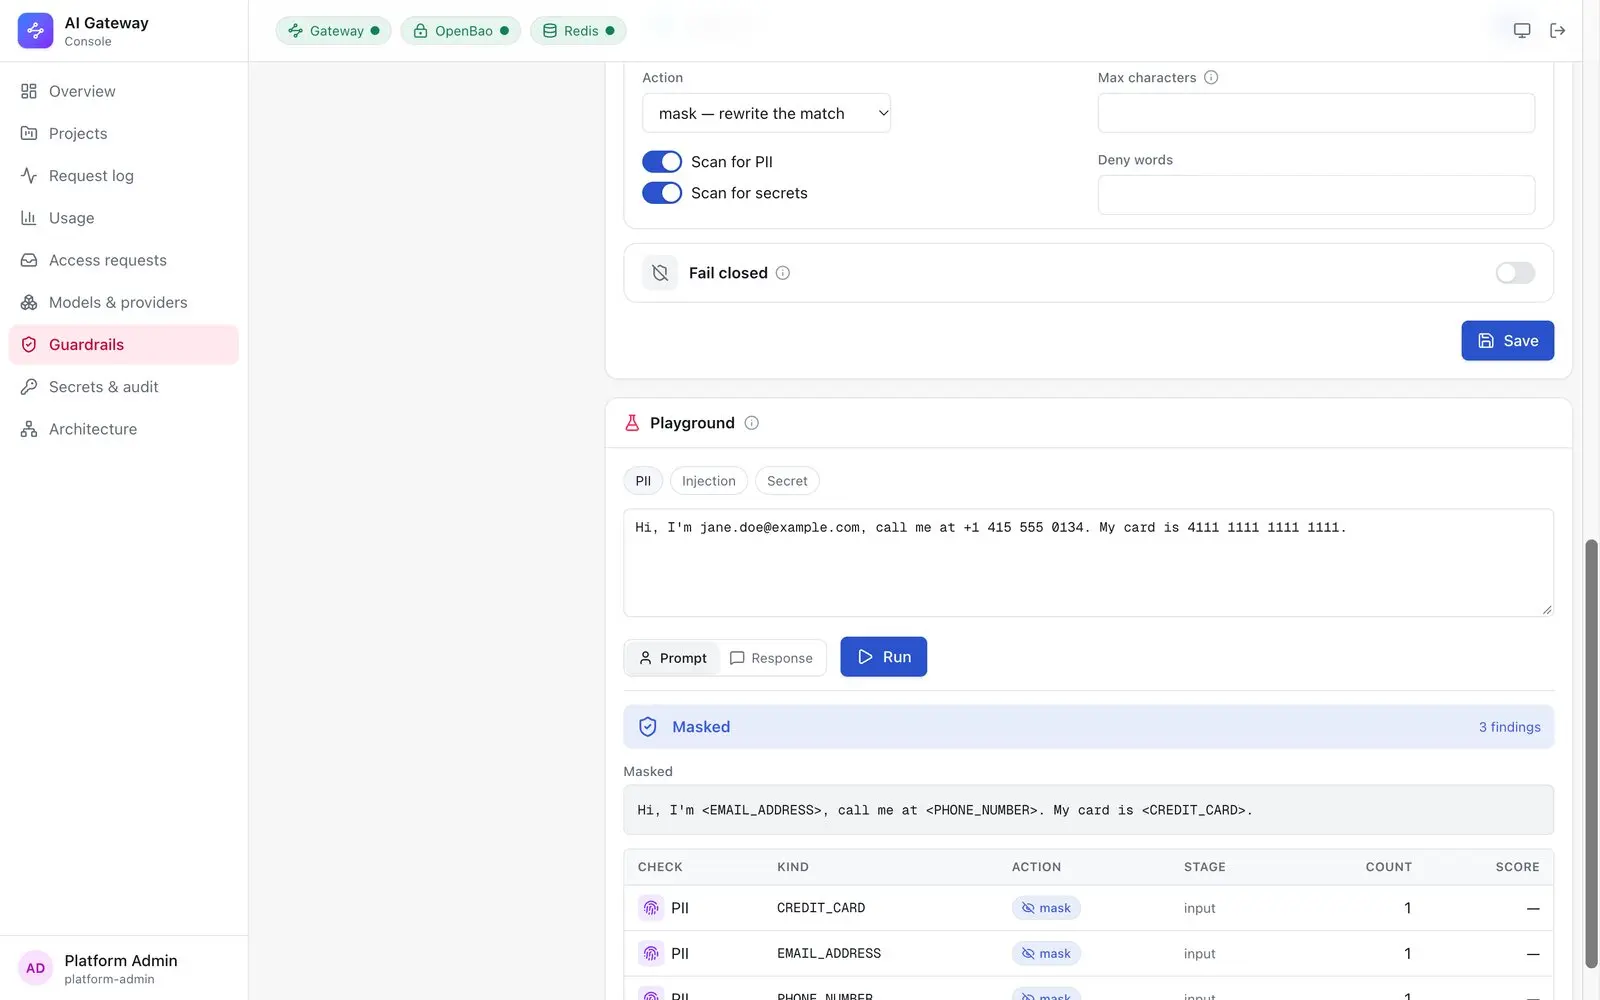
Guardarraíles por equipo. Cada proyecto elige una política, y cada comprobación (datos personales, secretos, inyección de prompts, palabras prohibidas, revisión de respuestas) puede bloquear, enmascarar o solo registrar. El playground prueba una política antes de activarla: un prompt con un correo, un teléfono y un número de tarjeta vuelve con los tres sustituidos por marcadores, que es lo que recibe el modelo. La detección de datos personales usa Microsoft Presidio en los servidores de la empresa, así que no hay coste por llamada y ningún tercero ve el texto. También se revisan las respuestas, incluidas las que llegan en streaming.
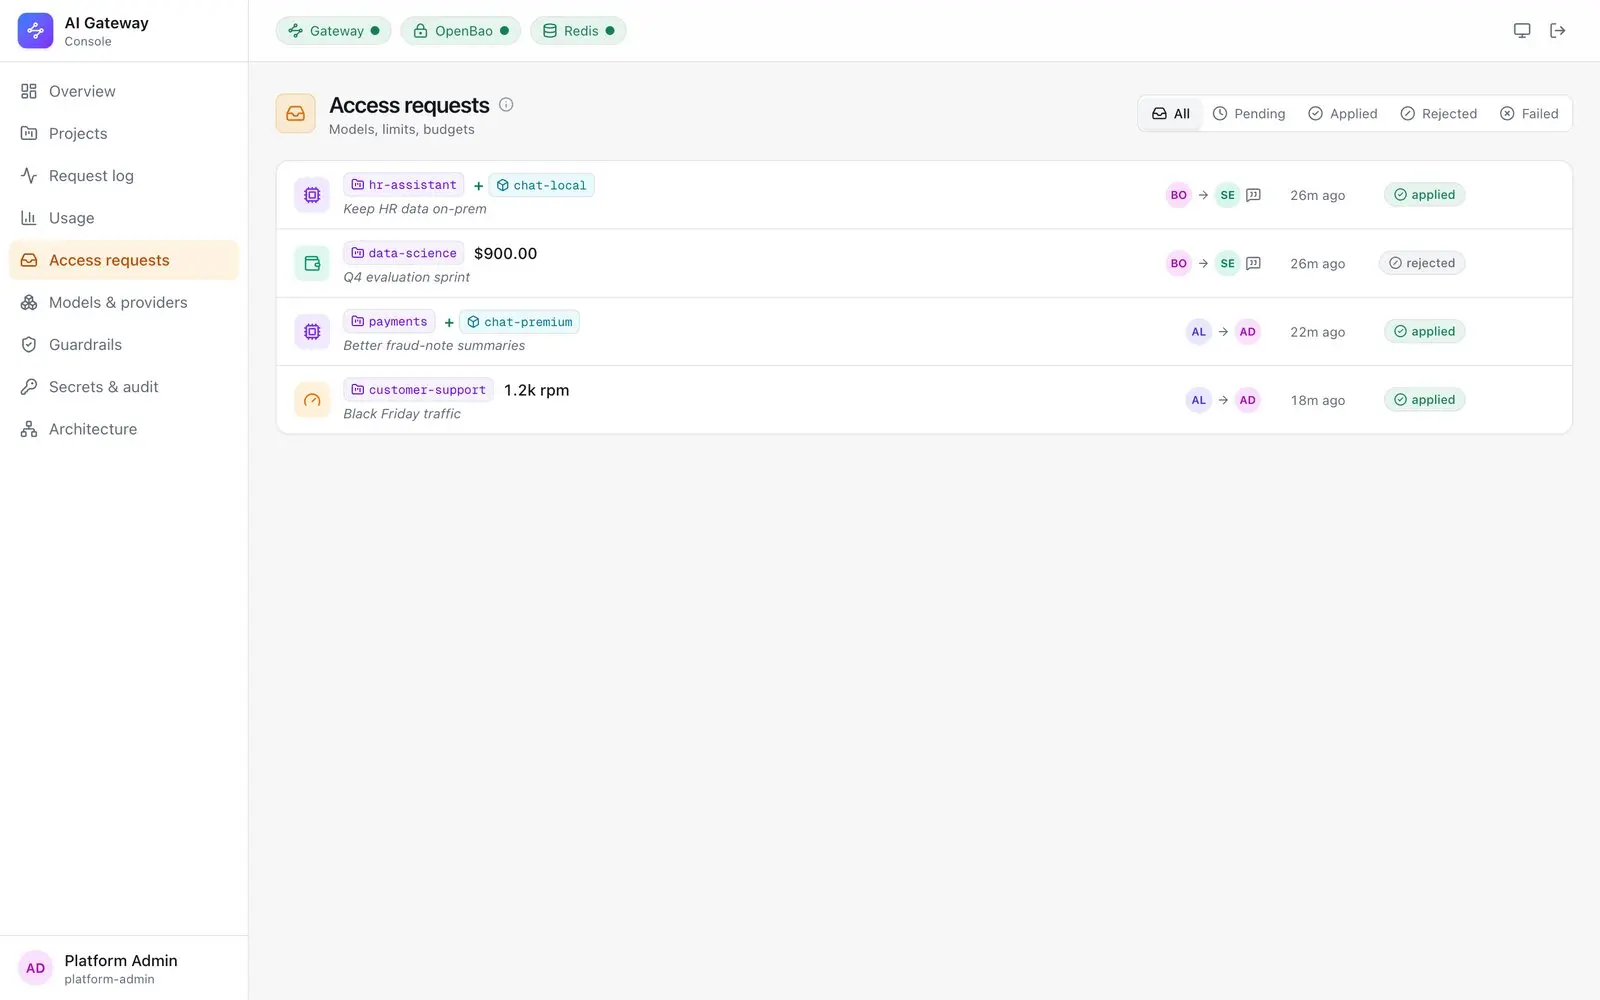
Los equipos piden, seguridad aprueba. El responsable de un proyecto pide un modelo, un límite mayor o más presupuesto, con un motivo. Un administrador de seguridad aprueba o rechaza, y la aprobación aplica el cambio en el gateway en segundos. Quién lo pidió, quién lo aprobó, cuándo y por qué queda registrado, y nadie puede aprobar su propia solicitud.
Se cambian modelos, no código. Las aplicaciones llaman a nombres estables como chat-default o chat-premium con el SDK estándar de OpenAI. El equipo de plataforma decide qué modelo hay detrás de cada nombre: OpenAI, Anthropic, Bedrock, Azure, Vertex AI o las GPU propias de la empresa con vLLM u Ollama. Las alternativas van de premium a default y a local. Un modelo de práctica integrado permite probar todo el sistema sin cuenta en ningún proveedor.
Arquitectura
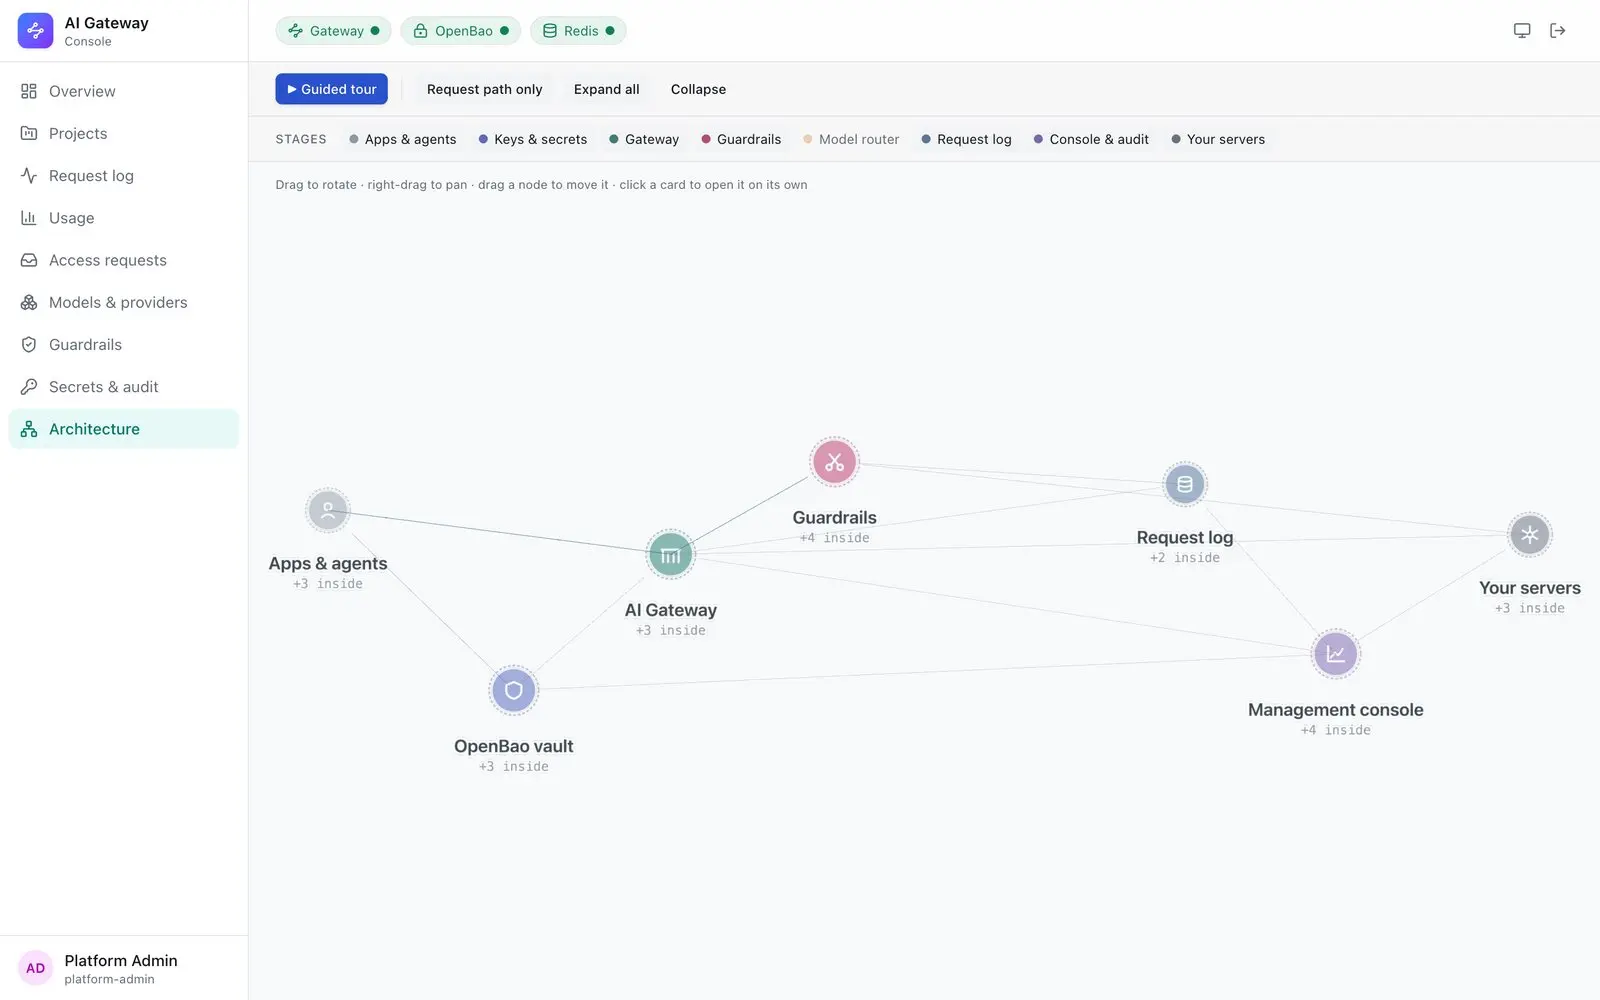
Una aplicación llama al gateway con su propia clave. LiteLLM comprueba la clave, la lista de modelos del equipo, sus límites de uso y su presupuesto. Después, mi plugin, escrito solo sobre los hooks públicos de LiteLLM, carga la política del proyecto (en caché durante 30 segundos y refrescada por Redis cuando la consola la cambia), aplica el límite por modelo y pasa los guardarraíles de entrada por cada texto que envía el usuario. El router de LiteLLM elige un despliegue para el alias, con reintentos y alternativas. Los guardarraíles de salida revisan la respuesta, y una fila del registro de peticiones guarda tokens, coste, latencia y hallazgos. Los prompts solo se guardan si el proyecto lo activa, cifrados con una clave de tránsito de la bóveda.
Las funciones que LiteLLM vende como Enterprise (integración con bóvedas, integraciones de guardarraíles, informes, inicio de sesión único) están construidas aquí sobre código abierto, sin importar nada de su código enterprise, y no hay licencia del gateway que pagar. El plano de control en FastAPI mantiene coherentes LiteLLM, OpenBao y Postgres en cada cambio y deshace lo hecho si un paso falla. La consola Next.js inicia sesión con Keycloak, así que la plantilla usa su cuenta de la empresa, y ofrece cuatro roles: administrador de plataforma, administrador de seguridad, responsable de proyecto y lector.
El mismo gateway en AWS
Los clientes que prefieren servicios gestionados obtienen las mismas ideas en su nube. Como ejemplo construí un copiloto corporativo sobre Amazon Bedrock AgentCore que responde preguntas de los empleados sobre los datos de la empresa y a cada persona solo le muestra las tablas, columnas y filas que puede ver.
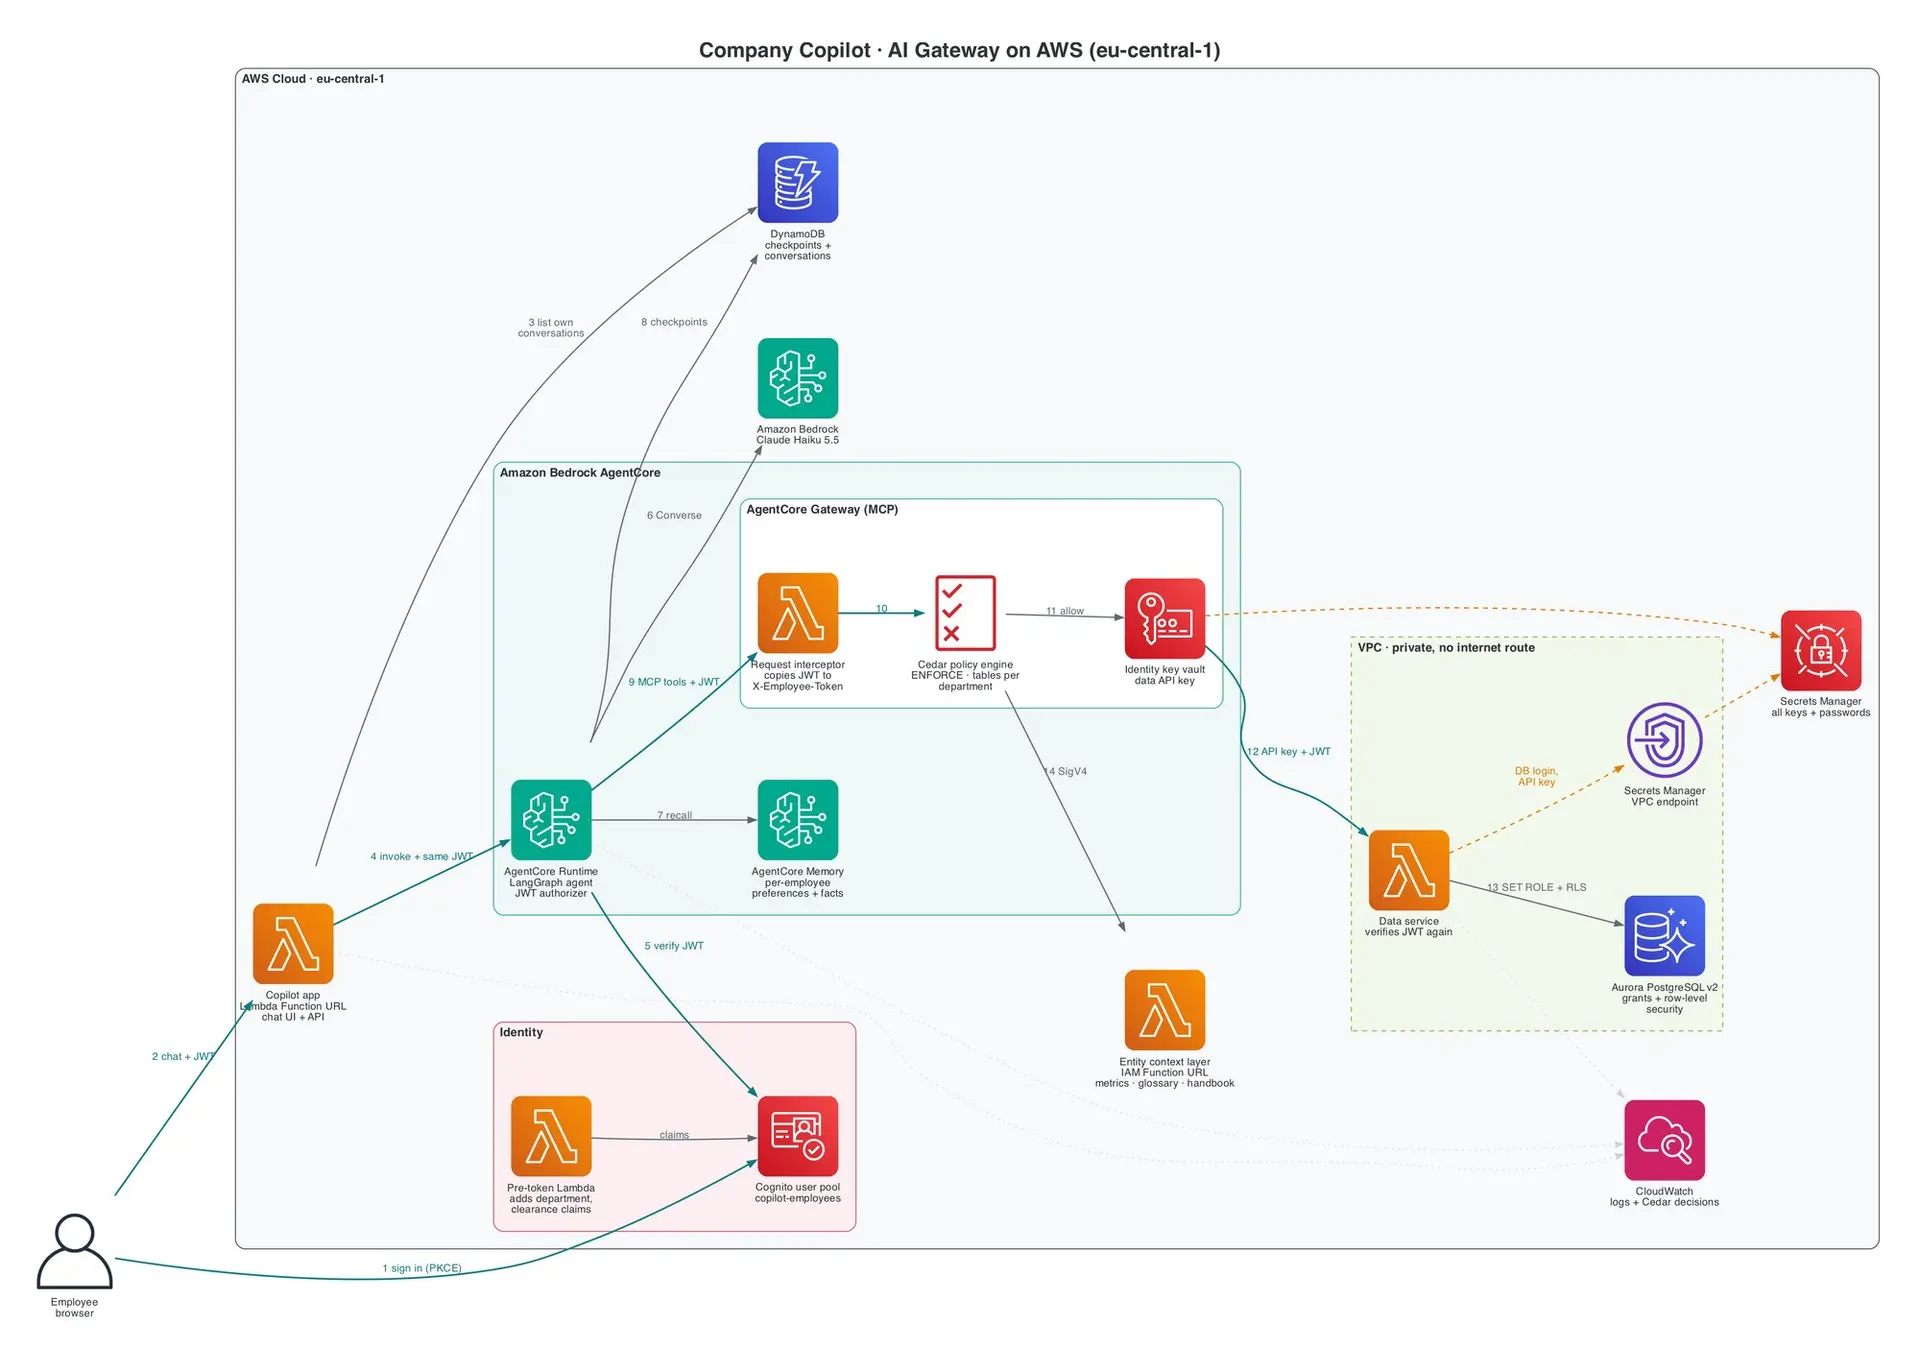
- Primero decide el gateway. AgentCore Gateway expone las herramientas de datos y de contexto por MCP. Su autorizador JWT comprueba el token de Cognito del empleado, y una política Cedar decide qué herramientas y tablas puede usar cada departamento y nivel de autorización. Las columnas restringidas se rechazan antes de que la petición llegue a los datos, y no se permite nada que escriba.
- Después vuelve a decidir la base de datos. Un servicio de datos en una VPC privada verifica el token otra vez, cambia al rol de Postgres del departamento y fija el identificador del empleado para la transacción. Los permisos de Aurora limitan tablas y columnas, y la seguridad a nivel de fila limita las filas a los registros del propio empleado, su línea jerárquica, su departamento, su región o su nivel de autorización.
- El agente nunca maneja la identidad. Las herramientas no reciben identificadores de usuario. El token del empleado viaja desde el navegador, pasando por el agente y el gateway, hasta la sesión de la base de datos, así que un prompt persuasivo no puede cambiar quién pregunta. Además, un segundo modelo revisa cada mensaje en busca de intentos de saltarse las reglas, como defensa en profundidad.
- Piezas gestionadas. LangGraph con Claude en Bedrock se ejecuta en AgentCore Runtime, AgentCore Memory guarda las preferencias de cada empleado, DynamoDB guarda los checkpoints y todas las claves y contraseñas viven en AWS Secrets Manager. 129 tests locales cubren la matriz de accesos, los servicios, la política Cedar y el agente de extremo a extremo, y otros 10 se ejecutan contra la pila desplegada.
El mismo patrón se traslada a Azure (el gateway de IA de API Management con límites de tokens y Content Safety) y a Google Cloud (Apigee con Model Armor). El mapa mental de AI Gateways compara las opciones.
Seguridad y pruebas
Las aplicaciones solo llegan al gateway y a la bóveda; solo el gateway puede llegar a los proveedores de modelos. Las claves de los proveedores existen en la bóveda y en la memoria del gateway, nunca en ficheros de entorno, valores de Helm ni en la consola. El plano de control puede escribir claves de proveedor pero no leerlas de vuelta. Cada cambio en la consola escribe una fila de auditoría, y el registro de auditoría de la bóveda anota cada lectura de un secreto. LiteLLM está fijado por etiqueta y digest de imagen tras los incidentes de 2026 con versiones comprometidas, y la actualización incluye una verificación de firma. Los 44 tests cubren guardarraíles, límites y rotación en vivo, y los 16 de extremo a extremo demuestran lo anterior: las lecturas entre proyectos reciben 403, una clave revocada deja de funcionar en todas partes en 5 segundos como máximo, las claves rotan sin reiniciar, las llamadas por encima del límite reciben 429 y cada petición bloqueada se registra exactamente una vez.
Las capturas usan una empresa de demostración, y el historial de los gráficos incluye datos de demostración generados.
Proyectos relacionados
AI Jobs MCP: servidor MCP remoto con Google OAuth en AWS Lambda
IA y agentes · Cloud, DevOps y LLMOps · Seguridad y cumplimiento
CareLens: IA clínica en Kubernetes y Azure, lista para HIPAA
Cloud, DevOps y LLMOps · Seguridad y cumplimiento · IA y agentes
Azure AI Automation: documentos, RAG y agentes con aprobación humana
IA y agentes · Cloud, DevOps y LLMOps · Seguridad y cumplimiento